Archives par mot-clé : intelligence artificielle

HackerBooks : les livres recommandés sur Hacker News

Vous cherchez un livre de programmation, de maths ou simplement une idée de lecture qui sort des classements habituels ? HackerBooks rassemble les ouvrages évoqués sur Hacker News depuis 2007. L’intérêt n’est pas seulement de voir quels titres reviennent souvent : le site essaie aussi de distinguer un livre cité au détour d’une discussion d’un livre réellement conseillé. Et cette nuance change pas mal de choses.

HackerBooks transforme les discussions en bibliothèque

Les utilisateurs de Hacker News échangent depuis des années des recommandations dans les commentaires. Le problème, c’est qu’une bonne suggestion peut vite disparaître sous une pile de nouvelles discussions. HackerBooks remet de l’ordre dans tout ça : 15 766 livres ont été recensés à partir de 281 363 mentions publiées depuis 2007.

Pour figurer dans la bibliothèque, un ouvrage doit avoir été cité par au moins deux personnes différentes. Ce seuil ne garantit pas qu’il soit excellent, bien sûr, mais il évite de construire tout un catalogue sur des mentions isolées. On obtient ainsi un point d’entrée pratique pour retrouver des livres dont plusieurs personnes ont parlé.

Les ouvrages sont répartis dans des rubriques comme la programmation, les mathématiques, la philosophie ou la fiction. Chaque fiche permet aussi de revenir aux commentaires associés. C’est à mon avis la partie la plus utile : un titre seul donne une piste, une discussion aide à comprendre pourquoi il mérite votre temps.

Une citation n’est pas une recommandation

C’est le piège classique des classements fondés sur la popularité. Un livre peut être mentionné parce qu’il a marqué un domaine, parce qu’il suscite un désaccord ou simplement parce qu’il répond à une question précise. Compter toutes ces occurrences comme des recommandations donnerait une image trompeuse.

HackerBooks utilise l’IA pour séparer les citations des recommandations. Prenez The Art of Computer Programming, de Donald Knuth : 1 125 personnes l’ont cité, mais 336 l’ont recommandé. Le premier chiffre mesure sa présence dans les conversations ; le second tente de mesurer l’envie de le conseiller. Ce n’est pas du tout la même information.
Différence entre citations et recommandations de livres dans HackerBooks

J’aime bien cette distinction parce qu’elle pousse à regarder derrière les chiffres. Si vous cherchez votre prochaine lecture, un ouvrage très cité n’est pas automatiquement celui par lequel commencer. Il vaut mieux lire quelques commentaires pour voir à qui il s’adresse, ce que les lecteurs en ont retenu et dans quel contexte ils le proposent.

Comment trouver une lecture qui vous correspond ?

Une grosse bibliothèque peut rapidement devenir une nouvelle façon de perdre du temps. Le plus simple est de partir d’un besoin concret, puis de confronter les suggestions aux discussions. Par exemple :

  • Choisissez une rubrique liée à ce que vous voulez découvrir ou approfondir.
  • Repérez les livres recommandés, sans vous arrêter au nombre total de citations.
  • Ouvrez les commentaires pour comprendre les avis et le niveau attendu.
  • Comparez plusieurs titres avant de décider lequel vous donnera vraiment envie de lire.

Le site propose aussi des suggestions personnalisées en fonction des fiches ouvertes. Cela peut aider à prolonger l’exploration, surtout quand un ouvrage vous intrigue sans être exactement ce que vous cherchiez. Mais je garderais la main sur le choix final : une suggestion automatique connaît vos clics, pas forcément vos objectifs.

Une bonne idée, à utiliser avec un peu de recul

HackerBooks a été codé avec Claude à la demande de Roansh. Dans le même esprit, HackerTube rassemble des vidéos recommandées sur Hacker News. Je trouve ces projets intéressants parce qu’ils donnent une forme utilisable à des années d’échanges dispersés. L’IA sert ici à organiser et à trier, plutôt qu’à inventer une liste de lectures sortie de nulle part.

Il reste une précaution importante : le classement des recommandations repose sur une interprétation automatique. Le contexte d’un commentaire peut être subtil, et un livre peut être confondu avec un autre. Si une fiche vous semble étrange, les discussions restent le meilleur endroit pour vérifier ce que les personnes voulaient dire. Il est également possible de signaler une erreur au créateur du site.

Enfin, HackerBooks n’est pas une bibliothèque de fichiers à télécharger : les fiches orientent vers des vendeurs de livres. Son intérêt est ailleurs, dans la découverte et dans l’accès aux échanges autour des ouvrages. Si vous avez envie d’apprendre quelque chose de nouveau, c’est une bonne porte d’entrée. Reste ensuite le plus difficile : choisir un livre, le commencer et aller jusqu’au bout.

Source : https://korben.info/hackerbooks-hackertube-hacker-news.html
Trunk-based development : la fin des pull requests

Le trunk-based development revient dans les discussions dès qu’on parle de code produit avec l’aide de l’IA. Puisque les modifications arrivent plus vite, pourquoi attendre une pull request, une revue et une fusion pour les intégrer ? Mais supprimer une étape ne supprime pas le travail qu’elle accomplissait. Il faut décider où placer ce travail, et comment vérifier qu’il est bien fait.

Je préfère une petite modification intégrée rapidement à une grosse pull request qui attend plusieurs jours. Pour autant, je ne donnerais pas les clés de la branche principale à toute l’équipe au seul motif qu’un assistant IA aide à écrire le code. La vitesse est utile si elle réduit aussi le délai entre une erreur et sa détection.

Trunk-based development : ce qu’on change vraiment

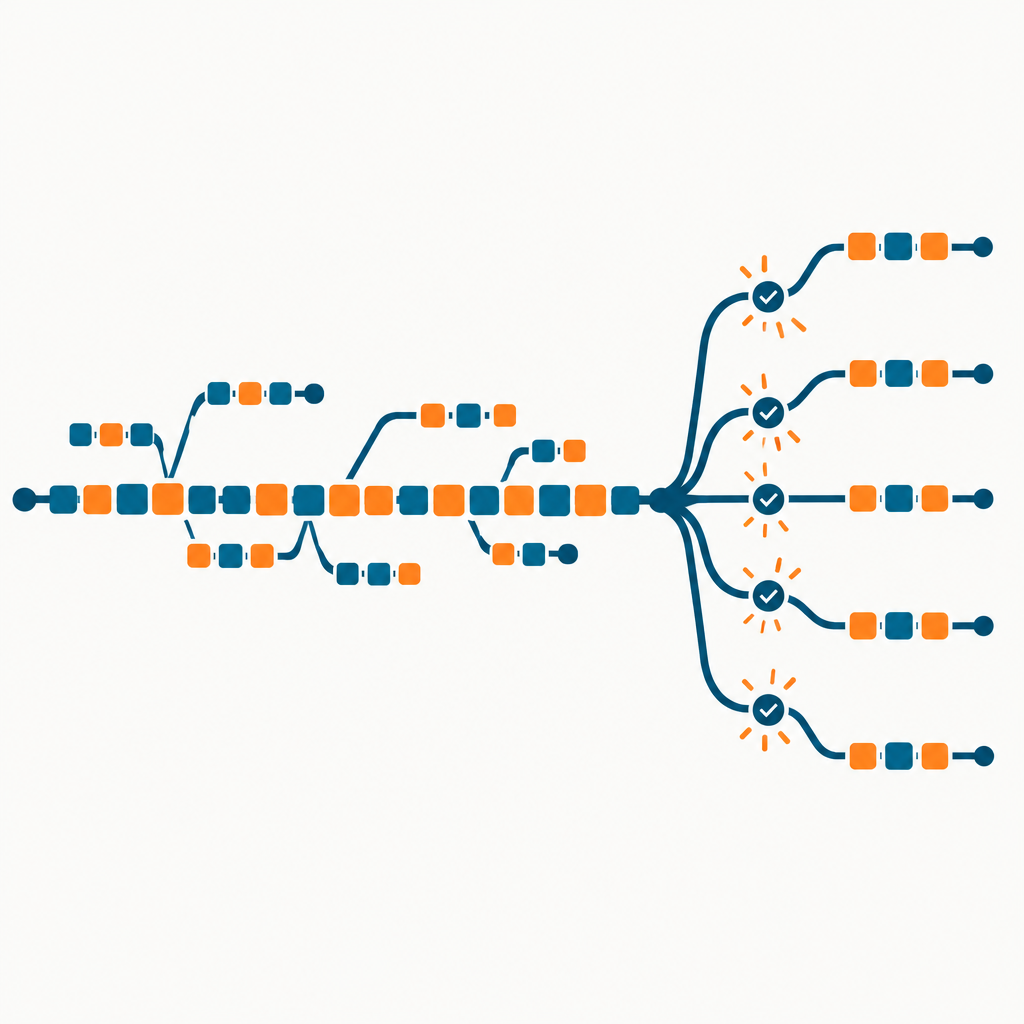
Le principe du trunk-based development consiste à intégrer fréquemment de petites modifications dans une branche principale commune. On évite ainsi que chacun travaille trop longtemps dans son coin, avec une branche qui diverge progressivement du reste du projet. Ce n’est pas forcément « plus de branches du tout » : des branches très courtes peuvent garder leur place.

La différence importante se situe dans la taille et la durée de vie du travail isolé. Une branche ouverte pour quelques heures et une pull request relue rapidement restent compatibles avec cette logique. À l’inverse, une fonctionnalité complète développée pendant des semaines avant fusion rend l’intégration plus risquée, même si elle passe par une revue formelle.

Le débat « pull requests ou trunk » devient trompeur quand il oppose deux boutons dans une interface Git. Une pull request est un moyen de discuter et de contrôler une modification. Le trunk-based development est une manière d’organiser le flux de travail.

Ce que l’IA accélère, et ce qu’elle ne vérifie pas

Un assistant peut proposer du code, des tests ou une première explication d’un changement. C’est pratique pour avancer. Mais une proposition rapide n’est pas automatiquement une modification pertinente. Il reste à vérifier qu’elle répond au besoin, s’intègre au projet et ne dégrade pas un comportement moins visible.

C’est là que je serais prudent avec l’idée de rendre les pull requests obsolètes. Si l’IA augmente le volume de code produit, elle peut aussi augmenter le volume de code à comprendre. Déplacer ce volume directement sur la branche principale, sans ajuster les contrôles, ne me semble pas être un progrès.

Avant d’intégrer une modification, je garderais au minimum quelques questions en tête :

  • Le changement est-il assez petit pour être compris et annulé facilement ?
  • Les tests vérifient-ils le comportement qui compte, et pas seulement le chemin le plus évident ?
  • Une personne connaît-elle la raison du changement, même si l’IA a participé à son écriture ?
  • Que se passe-t-il si cette modification casse quelque chose après l’intégration ?

Ces questions ne réclament pas nécessairement une longue revue asynchrone. Elles réclament en revanche une réponse. Selon les équipes, elle peut prendre la forme d’une revue courte, d’un échange en binôme, de contrôles automatisés ou d’une combinaison des trois.

Comparaison visuelle entre branche longue et intégrations fréquentes sur le trunk

Des petits changements, pas des contrôles en moins

À mes yeux, le principal intérêt du trunk-based development n’est pas de gagner quelques clics dans Git. C’est de rendre chaque changement assez limité pour qu’on puisse le comprendre, le tester et, si besoin, revenir en arrière. La taille des modifications devient alors un outil de maîtrise du risque.

Prenons une fonctionnalité qui touche à la base de données, au traitement métier et à l’interface. Tout livrer d’un coup complique la revue comme le diagnostic en cas de problème. La découper en étapes cohérentes permet de vérifier chaque partie plus tôt. Mais il faut préparer ces étapes : un changement intermédiaire ne doit pas casser le fonctionnement existant.

Les feature flags peuvent aider à séparer l’intégration du code de l’activation d’une fonctionnalité. Le code rejoint la branche principale, tandis que la nouveauté reste désactivée pour les utilisateurs concernés jusqu’à ce qu’elle soit prête. Ce n’est pas une solution magique : les états activé et désactivé doivent être testés, et les flags devenus inutiles doivent être retirés.

Je retiens surtout une règle pratique : si une modification paraît impossible à intégrer sans tout terminer auparavant, il faut regarder si on peut la découper autrement. Ce n’est pas toujours facile, notamment lorsqu’une migration touche plusieurs composants. Mais cette difficulté mérite d’être traitée comme un problème de conception, pas cachée dans une branche de longue durée.

Ce qu’il faut préparer avant de changer de méthode

Intégrer plusieurs fois par jour suppose une branche principale sur laquelle l’équipe peut travailler sans appréhension. Pour y parvenir, il faut plus qu’une consigne du type « faites des petits commits ». Les tests doivent être utiles, leur résultat doit arriver assez vite, et un échec doit être pris en charge rapidement.

Je commencerais par observer le fonctionnement actuel plutôt que par interdire les pull requests. Combien de temps une modification attend-elle une revue ? Quelle taille font les changements difficiles à relire ? Quels tests échouent régulièrement sans signaler un vrai problème ? Ces questions montrent où le travail ralentit et où la confiance manque.

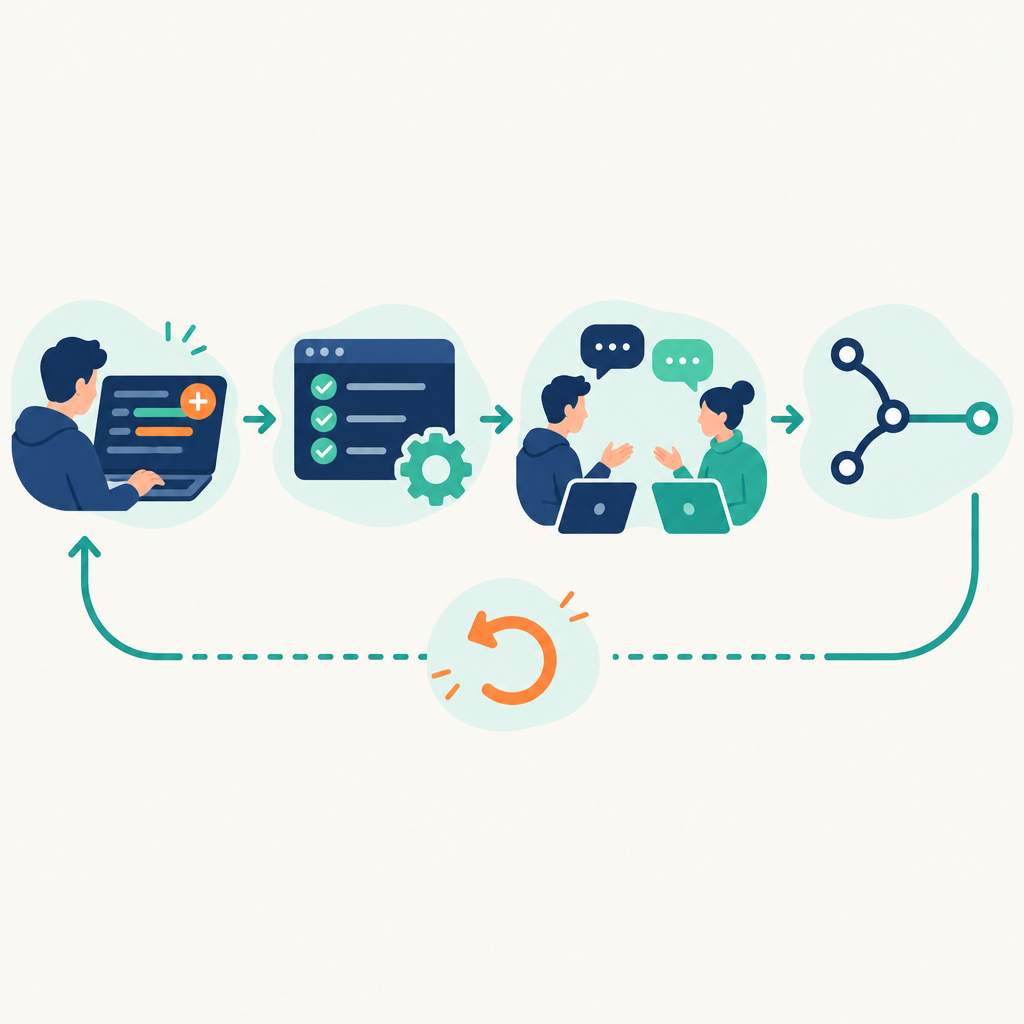
Ensuite, je ferais évoluer les habitudes progressivement :

  1. Découper une tâche en changements plus petits, chacun avec un objectif compréhensible.
  2. Automatiser les vérifications que l’équipe répète déjà à chaque revue.
  3. Conserver une intervention humaine ciblée sur les choix de conception, les cas sensibles et les risques métier.
  4. Prévoir comment désactiver une fonctionnalité ou revenir sur un changement problématique.
  5. Vérifier régulièrement si le délai d’intégration baisse sans multiplier les incidents.

Ce dernier point est important. Une équipe peut fusionner beaucoup plus vite tout en passant davantage de temps à réparer. Elle n’a alors fait que déplacer l’attente : elle n’est plus devant la pull request, elle se retrouve après la mise en production.

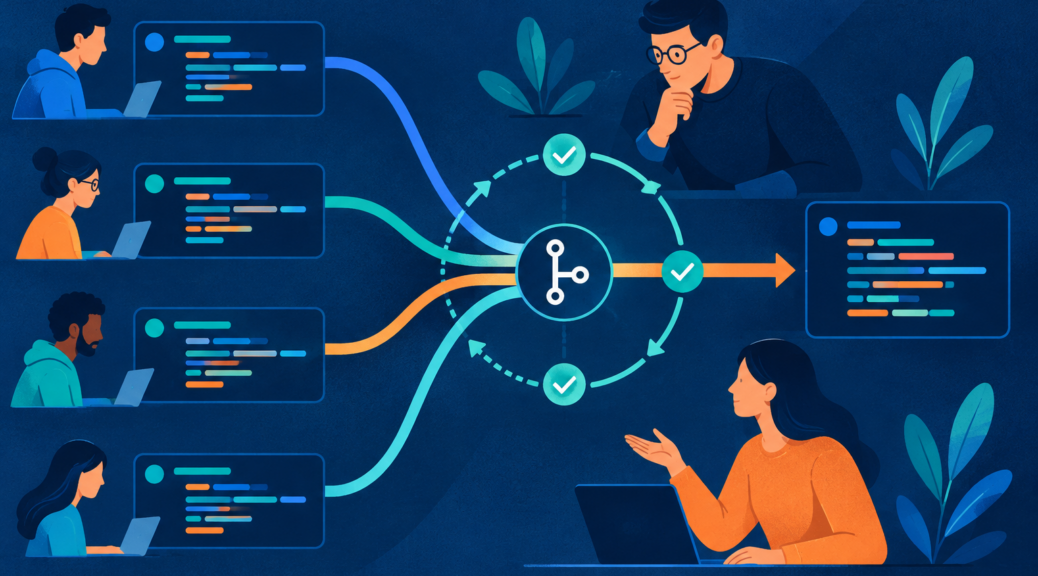
Flux de vérification et d’intégration de petits changements de code

Faut-il vraiment supprimer les pull requests ?

Je ne le ferais pas par principe. Dans une petite équipe qui échange souvent, une revue rapide avant fusion peut rester légère et utile. Dans un projet ouvert aux contributions extérieures, la pull request offre aussi un espace clair pour expliquer le changement et en discuter. Et certains changements sensibles justifient un contrôle explicite avant d’atteindre la branche principale.

En revanche, une pull request qui reste ouverte longtemps parce que personne n’a le temps de la lire ne protège pas grand-chose. Elle accumule les conflits, retarde les retours et finit parfois par être validée dans l’urgence. Dans ce cas, la bonne réponse n’est pas nécessairement de supprimer les revues : c’est de réduire leur taille et de leur réserver une vraie place dans le travail de l’équipe.

L’IA rend cette discipline encore plus importante. Si produire une modification prend moins de temps, comprendre pourquoi elle existe et vérifier ses effets ne doit pas devenir une formalité. La responsabilité du code reste humaine, qu’il ait été écrit à la main ou suggéré par un outil.

Au fond, je ne choisirais pas entre « tout passe par une pull request » et « tout part directement sur le trunk ». Je chercherais le circuit le plus court qui permette encore de comprendre, tester et corriger chaque changement. C’est moins spectaculaire qu’une révolution des méthodes de développement, mais probablement plus utile au quotidien.

Source : https://alm.developpez.com/actu/388617/Des-developpeurs-estiment-que-les-Pull-Requests-sont-obsoletes-a-l-ere-de-l-IA-et-proposent-d-aller-au-Trunk-Based-Development-Tout-le-monde-integre-son-travail-sur-une-seule-branche-plusieurs-fois-par-jour/

Claude bouscule les tests de recrutement des développeurs

Le recrutement des développeurs repose souvent sur un exercice bien connu : résoudre un problème de programmation sous les yeux d’un recruteur. Mais que mesure encore ce test lorsqu’une IA peut le réussir mieux que la plupart des candidats ? Chez Anthropic, un responsable a choisi de le retirer des entretiens de son équipe. Ce n’est pas la fin des évaluations techniques, mais c’est un signal intéressant sur ce qu’elles doivent désormais vérifier.

Pourquoi Claude change le recrutement des développeurs

Felix Rieseberg, qui a dirigé le développement technique de Claude.ai et de l’application de bureau Claude Code, a supprimé un entretien de code du processus de recrutement de son équipe. Son raisonnement est simple : Claude réussit désormais si bien ce type d’exercice que le résultat ne lui apporte plus assez d’informations utiles sur les candidats.

Un test de programmation avait pourtant un intérêt. Il permettait d’observer comment une personne comprenait une consigne, décomposait un problème et avançait vers une solution. Ce n’était pas une mesure parfaite de ses capacités, mais cela donnait un aperçu de sa manière de travailler. Si l’exercice ressemble surtout à un défi court et prévisible, sa réussite devient moins révélatrice.

Attention à la portée de cette décision : un responsable retire un test pour son équipe. Anthropic n’a pas annoncé la disparition de toutes ses évaluations techniques. La question n’est pas de savoir s’il faut encore tester les développeurs, mais comment le faire utilement.

Un test de code confronté aux capacités de Claude pour le recrutement des développeurs

Des exercices de plus en plus difficiles à calibrer

Une autre équipe d’Anthropic a rencontré le même problème avec un test à réaliser à domicile. Son responsable, Tristan Hume, a constaté que Claude Opus 4 obtenait de meilleurs résultats que la majorité des candidats dans le temps prévu. Il a d’abord augmenté la difficulté de l’épreuve.

Puis Opus 4.5 a atteint le niveau des meilleurs candidats sur cette nouvelle version. Une troisième mouture a donc été conçue autour de problèmes plus inhabituels, proches de jeux de réflexion, que le modèle n’est pas parvenu à résoudre. Cette succession de changements montre à quel point un test peut perdre rapidement sa valeur si les outils disponibles progressent plus vite que l’exercice lui-même.

Rendre une épreuve toujours plus difficile n’est toutefois pas forcément la meilleure réponse. Un problème très éloigné du travail quotidien peut départager des candidats sans aider à savoir qui saura maintenir une application, comprendre un besoin ou collaborer avec une équipe. Le bon test doit rester lié au poste, pas devenir une compétition de casse-têtes.

Que faut-il vraiment évaluer chez un développeur ?

Écrire du code n’est qu’une partie du métier. Dans un projet réel, il faut aussi choisir entre plusieurs solutions, lire l’existant, repérer les risques et expliquer ses décisions. L’arrivée d’assistants capables de produire rapidement une première réponse donne davantage de poids à ces compétences.

Une évaluation technique peut, par exemple, chercher à observer :

  • la façon dont le candidat clarifie un besoin avant de développer ;
  • sa capacité à relire, tester et corriger une solution ;
  • les compromis qu’il fait entre simplicité, performance et maintenance ;
  • sa manière d’expliquer ce qu’il comprend et ce qu’il vérifierait.

Ces pistes ne rendent pas les tests infaillibles. Elles déplacent simplement l’attention du résultat brut vers le raisonnement et les choix. Un programme qui fonctionne ne suffit pas toujours à montrer comment il se comportera une fois intégré à un produit utilisé et maintenu par d’autres.

Évaluation des compétences d'un développeur lors d'une discussion technique
Évaluation des compétences d’un développeur lors d’une discussion technique

Interdire l’IA ou adapter les entretiens ?

Anthropic interdit aux candidats d’utiliser Claude pendant les entretiens et les tests à domicile, sauf indication contraire. Cette règle vise à savoir ce qu’une personne peut faire elle-même. Elle ne résout pourtant qu’une partie du problème : même sans aide pendant l’épreuve, un exercice devenu trop facile pour l’IA peut ne plus distinguer efficacement les candidats.

Les entreprises cherchent aussi à encadrer davantage leurs évaluations. Dans une enquête menée auprès de 1 500 employeurs, 62,5 % des entreprises du secteur de l’information déclaraient demander des tests formels de compétences dès la candidature initiale. Environ 70 % avaient modifié leurs modalités, notamment avec des sessions surveillées ou en présentiel, pour limiter l’usage de l’IA.

La surveillance permet de fixer une règle claire, mais elle ne dispense pas de se demander ce que le test mesure réellement. À l’inverse, autoriser l’IA peut avoir du sens si l’objectif est d’observer comment un candidat utilise un outil, contrôle ses réponses et garde la maîtrise du résultat. Les deux approches répondent à des questions différentes.

Le test de code n’est pas mort, son objectif doit être clair

Claude ne rend pas les compétences des développeurs inutiles. Il remet en cause certains raccourcis utilisés pour les évaluer. Un petit exercice réussi rapidement ne dit pas nécessairement qui saura résoudre les problèmes d’une équipe sur la durée.

Pour les recruteurs, l’enjeu est de concevoir des épreuves proches du travail attendu et d’expliquer la place autorisée à l’IA. Pour les candidats, il reste essentiel de pratiquer, de comprendre leur code et de pouvoir défendre leurs choix. Les outils évoluent ; la capacité à bien poser un problème et à juger une solution reste, elle, au cœur du métier.

Source : https://www.tomshardware.fr/claude-est-devenu-trop-fort-anthropic-supprime-un-test-de-recrutement-pour-ses-developpeurs/

Pourquoi nos yeux sautent des mots en lisant

Quand on lit, nos yeux ne “balayent” pas le texte de façon continue. Ils saccadent, se fixent brièvement… puis sautent certains mots. Et ce n’est pas un hasard : une équipe de chercheurs a entraîné un modèle d’IA pour reproduire ces mouvements et surtout expliquer pourquoi les yeux sautent des mots.

Lire, ce n’est pas regarder tout le texte

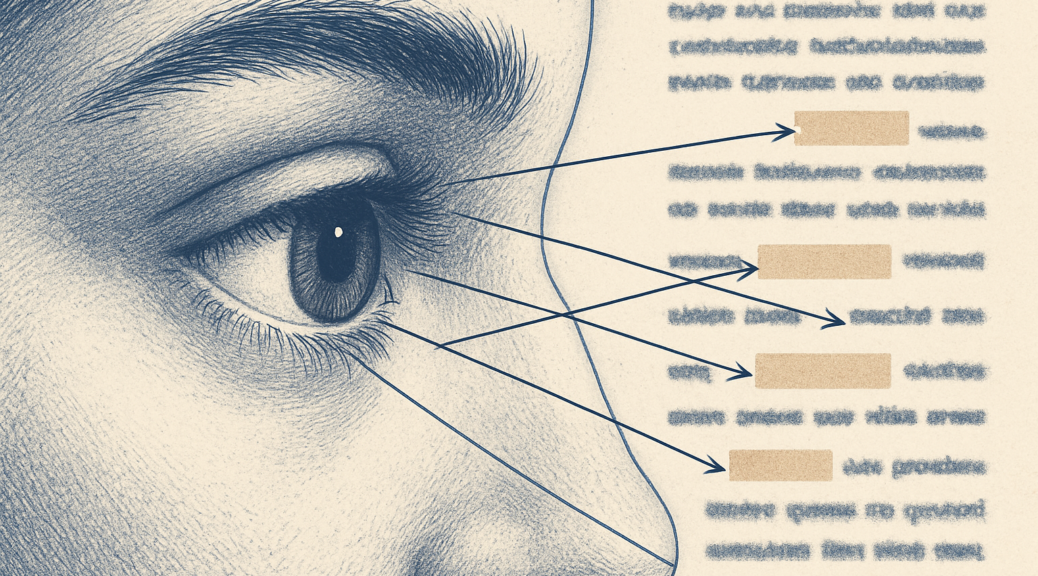
Le point de départ est simple : lors de la lecture, l’œil avance par fixations courtes, séparées par des saccades. Entre ces moments, une partie des mots n’est jamais fixée directement. Autrement dit, on ne “lit” pas chaque mot au sens visuel du terme : on sélectionne.

Jusqu’ici, plusieurs explications reposaient sur des règles assez fixes (par exemple liées à la longueur ou à la fréquence des mots). Le modèle présenté ici propose une approche plus souple : chaque décision de regard serait traitée comme un choix pris sous contrainte.

Fixations et saccades : certains mots ne sont pas fixés directement

Le modèle d’IA : décider quoi fixer, sous incertitude

Le cœur de la démarche consiste à traiter la lecture comme une suite de décisions. À chaque étape, le modèle évalue l’intérêt d’ajouter une fixation supplémentaire, en tenant compte du temps que cela coûte.

Concrètement, l’IA raisonne à trois niveaux :

  • le mot (ce qui est probable à venir),
  • la phrase (le contexte syntaxique),
  • le texte (la structure globale et l’orientation du sens).

Cette logique s’appuie sur une idée issue de la théorie de la décision : si le gain d’information attendu ne compense pas le coût temporel, l’œil a plus de chances de ne pas s’attarder sur certains mots.

Pourquoi les mots “faciles” sont plus souvent sautés

Le résultat le plus parlant concerne les mots qui semblent “prévisibles” pour le lecteur. Plus la confiance du modèle envers un mot à venir est élevée, plus ce mot risque d’être sauté.

Dans les données, ce sont surtout :

  • les mots courts,
  • les mots fréquents,
  • les mots prévisibles dans le contexte.

La tendance suit une logique intuitive : la probabilité de saut diminue quand le mot est plus long, et augmente quand il est plus fréquent. Autrement dit, si le cerveau (et ici le modèle) anticipe déjà ce mot, il n’a pas forcément besoin de le “vérifier” par une fixation directe.

Le rôle de la longueur et de la fréquence sur la fixation

Les modèles cognitifs plus anciens reliaient souvent fréquence et prévisibilité à des mouvements oculaires via des règles déterministes. Ici, l’idée est différente : la durée de fixation sur un mot augmente avec sa longueur, et diminue avec sa fréquence ou sa prévisibilité.

On observe aussi des régularités dans la manière dont l’œil se pose : il revient généralement entre le début et le milieu du mot, une constante appelée position de lecture préférée. Et quand la phrase comporte une ambiguïté syntaxique, le regard a davantage tendance à faire des retours en arrière.

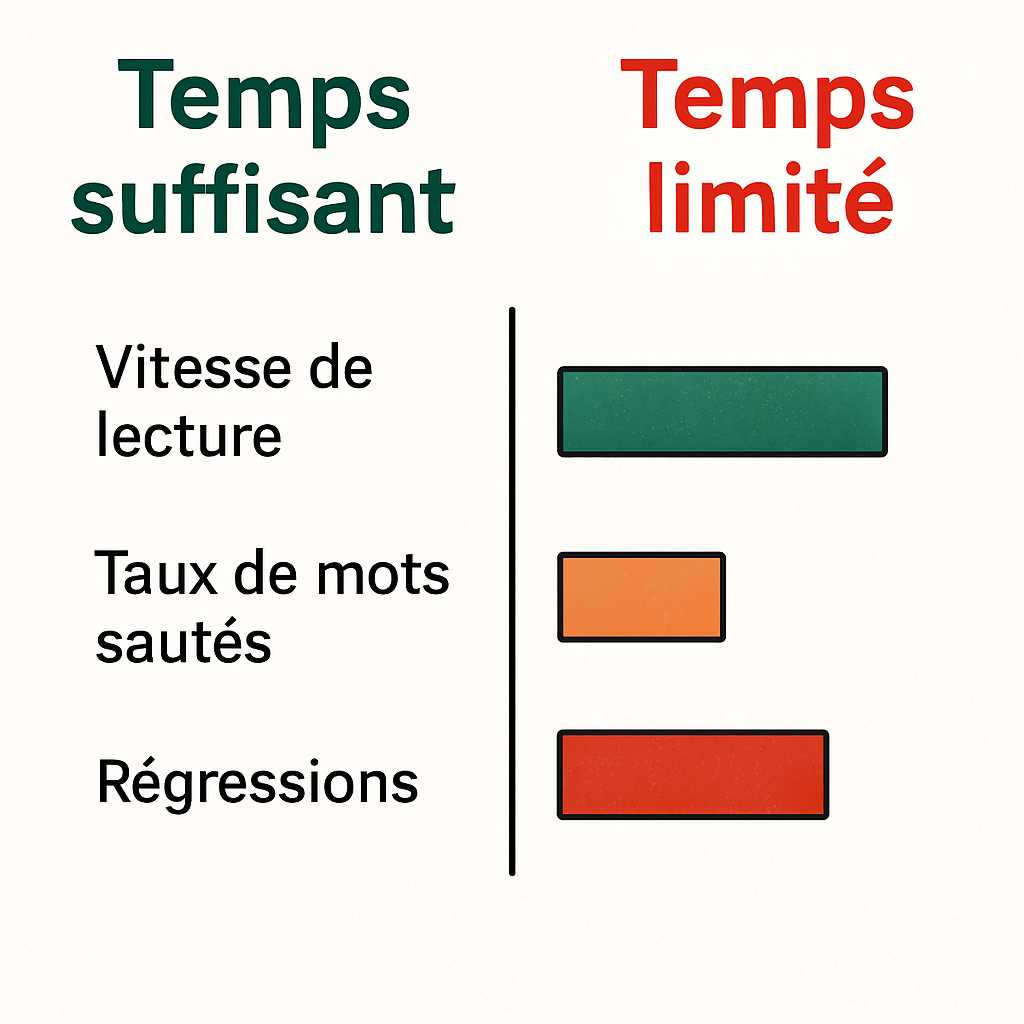
Quand le temps manque, les mots sont davantage sautés et les retours en arrière changent

Lecture sous contrainte : quand le temps manque, on optimise

Un autre apport important est la prise en compte du temps. Les chercheurs ont testé le mécanisme dans des conditions où la lecture doit se faire vite : des participants lisent des textes avec des limites de temps, puis répondent à des questions de compréhension.

Quand le temps augmente, on observe chez les humains une baisse de la vitesse de lecture. En parallèle, le taux de mots sautés recule et les retours en arrière (les régressions) augmentent. La compréhension progresse aussi.

Le modèle reproduit ces tendances : il “apprend” à adapter ses décisions quand la contrainte temporelle change. L’idée générale est que la lecture devient un arbitrage entre :

  1. couverture (avancer en sautant davantage, pour garder une vue d’ensemble),
  2. précision (investir plus de fixations et de retours quand on a le temps).

En situation de temps limité, l’œil privilégie la compréhension globale plutôt que le détail mot à mot.

Ce que ça change (vraiment) pour comprendre la lecture

Ce travail ne dit pas “les yeux sautent des mots parce que…”, comme une règle unique. Il montre plutôt une mécanique : la lecture ressemble à une gestion rationnelle des ressources sous incertitude.

On peut en tirer une lecture pratique : si un texte contient des mots très prévisibles, le lecteur peut les traiter sans fixation directe. À l’inverse, quand le contexte est ambigu ou que l’information est moins anticipable, l’œil revient, vérifie, et investit davantage.

Conclusion : des sauts qui servent la compréhension

Les yeux sautent des mots parce que lire, c’est décider quoi vérifier et quoi laisser passer, selon ce qui est probable et selon le temps disponible. L’IA met en lumière un principe : la lecture n’est pas une capture exhaustive du texte, mais une stratégie d’optimisation.

Et si vous voulez améliorer votre compréhension (ou concevoir des contenus plus lisibles), la question n’est peut-être pas “comment faire lire chaque mot”, mais plutôt “comment réduire l’ambiguïté et guider l’anticipation”.

Source : https://www.clubic.com/actualite-626332-une-ia-apprend-pourquoi-nos-yeux-sautent-des-mots-quand-nous-lisons.html

DeepClaude : pourquoi ça agite Claude Code

DeepClaude fait parler de lui parce qu’il touche à un point très sensible dans l’IA de développement : le prix. L’idée est simple sur le papier, mais redoutable dans ses conséquences possibles. Un projet open source propose de conserver l’environnement autonome de Claude Code, tout en remplaçant le modèle sous-jacent par DeepSeek V4 Pro. D’après la source, cela permettrait d’obtenir un coût d’inférence jusqu’à 17 fois moins élevé, avec des performances jugées comparables sur une large partie des tâches.

Dit autrement, ce n’est pas seulement un nouvel outil. C’est une manière de dissocier l’interface agentique, les automatismes et les outils d’un côté, et le moteur de génération de l’autre. Et cela pose immédiatement une question : si l’expérience reste proche, qu’est-ce qui justifie encore l’écart de prix ?

DeepClaude, c’est quoi exactement ?

Selon la source, DeepClaude est un projet open source publié sur GitHub qui reprend l’environnement agentique de Claude Code : boucle autonome, outils, interface, exécution de commandes, gestion de workflows et travail sur des dépôts de code. La différence, c’est que le modèle utilisé en arrière-plan n’est plus celui d’Anthropic, mais DeepSeek V4 Pro.

C’est un point important à comprendre. Ce qui intéresse beaucoup de développeurs dans Claude Code, ce n’est pas uniquement la qualité brute du modèle, mais l’ensemble de l’expérience : capacité à lire et modifier des fichiers, à enchaîner des étapes, à lancer des commandes bash, à travailler sur une base de code entière, voire à orchestrer des sous-tâches. DeepClaude s’inscrit précisément sur ce terrain.

Pourquoi le sujet du prix revient aussi fort

Le succès de ce type d’outil vient avec une contrepartie : l’usage agentique consomme beaucoup. Quand un assistant ne se contente plus de répondre à une question, mais explore un dépôt, relit des fichiers, propose des modifications, relance des commandes et itère, la facture peut grimper rapidement.

La source rappelle la structure tarifaire de Claude Code chez Anthropic :

  • un plan Pro à 20 dollars par mois présenté comme porte d’entrée ;
  • un plan Max 5x à 100 dollars par mois ;
  • un plan Max 20x à 200 dollars par mois ;
  • et, en dehors des abonnements, une utilisation via API potentiellement bien plus coûteuse.

Elle souligne aussi qu’un quota de 44 000 tokens sur une fenêtre de cinq heures peut devenir limitant pour des usages intensifs. Pour un développeur qui travaille longtemps sur une grosse base de code, cela n’a rien d’anecdotique. On comprend alors pourquoi toute solution promettant une forte baisse des coûts attire immédiatement l’attention.

La source cite même le cas d’un développeur ayant documenté une consommation de dix milliards de tokens sur huit mois d’usage quotidien, pour un coût estimé à plus de 15 000 dollars au tarif API, contre 800 dollars avec un abonnement Max à 100 dollars par mois. Même sans généraliser ce cas à tous les profils, l’ordre de grandeur suffit à expliquer la sensibilité du sujet.

Ce que DeepClaude change dans la discussion

Avec DeepClaude, le débat ne porte plus seulement sur la qualité d’un modèle, mais sur la valeur réelle de chaque couche du produit. Si l’environnement agentique peut être conservé et que le moteur peut être remplacé par un autre modèle moins cher, alors la proposition de valeur se déplace.

En clair, plusieurs éléments se retrouvent séparés :

  • l’interface et l’expérience utilisateur ;
  • la boucle autonome et les outils ;
  • le modèle de langage lui-même ;
  • la politique tarifaire associée.

Jusqu’ici, beaucoup d’acteurs vendaient un ensemble difficile à découper. Ce type de projet montre au contraire qu’une partie du marché cherche à modulariser l’IA de développement. Pour les utilisateurs, c’est potentiellement plus de liberté. Pour les fournisseurs, c’est aussi plus de pression concurrentielle.

Un contexte déjà tendu autour de Claude Code

La source rappelle un épisode qui a visiblement marqué la communauté : fin avril, Anthropic aurait modifié sa page tarifaire pour ne plus inclure Claude Code dans le plan Pro, en le réservant aux offres Max à 100 ou 200 dollars par mois, avant de revenir en arrière quelques heures plus tard.

Ce recul rapide montre au moins une chose : le sujet est explosif. Dès qu’un outil devient central dans les habitudes de travail des développeurs, toute évolution de prix ou de quota est perçue comme un risque direct. La réaction observée sur Reddit, Hacker News et Twitter, mentionnée dans la source, illustre bien cette dépendance croissante.

Dans ce contexte, l’arrivée d’un projet comme DeepClaude tombe au moment parfait. Il ne crée pas la frustration ; il capte une frustration déjà existante.

DeepSeek V4 Pro, l’autre pièce du puzzle

La source présente DeepSeek V4 Pro comme le modèle branché derrière DeepClaude. Elle indique qu’il est sorti le 24 avril 2026 et le décrit comme un modèle de type mixture of experts avec 1 600 milliards de paramètres totaux, dont 49 milliards activés par token.

À ce stade, il faut rester prudent : l’article source met surtout en avant le rapport coût/performance et le fait que les performances seraient comparables sur environ 80 % des tâches. C’est une information intéressante, mais qui demande toujours à être interprétée avec nuance. En pratique, tout dépend du type de tâches, du niveau d’exigence, du contexte de code, de la tolérance aux erreurs et de la façon dont les tests ont été menés.

Autrement dit, comparable ne veut pas dire identique. Mais dans un marché où le coût pèse lourd, être « assez proche » peut déjà suffire à changer les arbitrages.

Ce qu’il faut retenir pour les développeurs

Si l’on s’en tient aux faits rapportés par la source, DeepClaude est surtout le signe d’une évolution du marché. Les développeurs ne veulent plus seulement le meilleur modèle possible. Ils veulent aussi un outil soutenable, prévisible en coût, et adaptable à leurs usages réels.

Les points à retenir sont donc assez simples :

  1. le coût de l’IA agentique devient un sujet majeur ;
  2. les couches techniques se découplent de plus en plus ;
  3. l’open source accélère la remise en question des offres propriétaires ;
  4. la bataille ne se joue plus uniquement sur la qualité brute, mais sur le rapport entre prix, autonomie et confort d’usage.

Pour l’instant, DeepClaude apparaît surtout comme un révélateur. Il montre qu’un environnement de développement assisté par IA peut être perçu comme trop cher, même lorsqu’il est apprécié. Et il rappelle qu’en informatique, dès qu’une brique semble surtarifée, quelqu’un finit souvent par essayer de la remplacer.

La suite sera intéressante à observer. Si ce type d’approche se confirme, les éditeurs devront sans doute mieux justifier leur prix, ou revoir leur modèle. Et pour les développeurs, cela pourrait signifier davantage de choix, ce qui n’est jamais une mauvaise nouvelle.

Source : https://intelligence-artificielle.developpez.com/actu/382809/DeepClaude-l-environnement-autonome-de-Claude-Code-branche-sur-DeepSeek-V4-Pro-dix-sept-fois-moins-cher-que-l-inference-native-d-Anthropic-pour-des-performances-comparables-sur-80-pourcent-des-taches/

Akinator face à l’IA : la fin d’un mythe ?

Akinator, c’était ce site qu’on ouvrait pour épater les copains, en famille ou pendant une pause au bureau. On pensait à un personnage, on répondait à quelques questions, et le génie finissait presque toujours par trouver. Le problème, c’est qu’en relançant Akinator aujourd’hui, la magie semble bien moins évidente. Et ce décalage raconte quelque chose de plus large : notre rapport à la technologie a changé.

Ce n’est pas seulement l’histoire d’un vieux service web qui vieillit mal. C’est aussi celle d’un outil qui incarnait une forme d’intelligence fascinante à une époque donnée, avant d’être rattrapé par d’autres approches, bien plus souples et plus impressionnantes pour le grand public.

Akinator, un souvenir fort du web

Apparu sur le web en 2007, Akinator s’est imposé comme une curiosité numérique immédiatement mémorable. Le concept était simple, mais terriblement efficace : un génie posait une série de questions et tentait d’identifier le personnage auquel vous pensiez.

À l’époque, l’effet produit était réel. On essayait de le piéger avec des personnages secondaires, des célébrités oubliées ou des références improbables. Et malgré cela, il trouvait souvent. Il y avait là quelque chose de presque magique, au sens où Internet savait encore surprendre avec des mécaniques relativement simples en apparence.

Ce succès ne venait pas seulement de la technique. Il venait aussi de la mise en scène. Le personnage, son air sûr de lui, son sourire, son côté un peu moqueur : tout participait à l’expérience. Akinator n’était pas juste un moteur de questions-réponses, c’était un petit spectacle interactif.

Le personnage d’Akinator dans une illustration nostalgique

Pourquoi Akinator semble aujourd’hui moins convaincant

Le constat rapporté par la source est assez clair : en 2026, Akinator paraît plus lent, plus hésitant, parfois répétitif. Il peut reposer plusieurs fois la même question, multiplier les tentatives et finir par proposer un personnage sans rapport évident avec la recherche initiale.

Dit autrement, ce qui passait autrefois pour une prouesse bluffante donne aujourd’hui une impression d’essoufflement. Ce n’est pas forcément surprenant. Un système de ce type dépend fortement de la qualité de sa base de données et de la cohérence des réponses accumulées au fil du temps. Si les contributions se multiplient, se contredisent ou se dédoublonnent, le résultat devient mécaniquement moins propre.

On retrouve là un problème classique du numérique : un service peut être excellent à un instant donné, puis se dégrader non pas parce que l’idée est mauvaise, mais parce que son entretien, sa structure et son adaptation deviennent plus complexes avec les années.

Akinator vs l’IA : un changement de paradigme

Le point le plus intéressant est sans doute la comparaison entre Akinator et l’IA moderne. Elle est utile, à condition de ne pas tout mélanger.

Akinator repose sur une logique de système expert ou d’arbre de décision. En simplifiant, il élimine des possibilités au fur et à mesure de vos réponses. Il ne “comprend” pas réellement ce que vous dites au sens humain du terme. Il rapproche des caractéristiques, calcule des correspondances et tente de faire émerger l’option la plus probable.

L’IA générative ou prédictive, elle, donne une autre impression. Elle peut traiter des formulations floues, relier des concepts, absorber des masses d’informations bien plus vastes et répondre avec davantage de souplesse. Là où Akinator a besoin d’un cadre rigide, l’IA moderne paraît plus fluide, plus conversationnelle, plus tolérante à l’ambiguïté.

Il faut quand même garder la tête froide. Dire que l’IA “comprend” mieux n’implique pas qu’elle comprend comme un humain. Mais du point de vue de l’utilisateur, l’écart d’expérience est énorme. Et c’est cela qui condamne souvent les anciens outils : pas forcément leur inefficacité absolue, mais leur comparaison défavorable avec les nouveaux standards.

Ce que le déclin d’Akinator dit de notre époque

Le cas Akinator est intéressant car il montre à quelle vitesse une innovation peut changer de statut. Hier, elle paraissait presque magique. Aujourd’hui, elle semble datée. Non pas parce qu’elle a cessé d’exister, mais parce que le contexte technologique a complètement basculé.

On s’habitue très vite à la performance. Dès qu’un outil plus impressionnant apparaît, l’ancien perd son aura. C’est un mécanisme classique du web : on ne juge plus un service pour ce qu’il a représenté, mais pour ce qu’il vaut face aux usages actuels.

Et pourtant, il ne faut pas être injuste. Akinator a aussi été une porte d’entrée vers une certaine culture numérique. Il montrait qu’avec des données, des règles et une bonne interface, on pouvait fabriquer une expérience mémorable. Beaucoup d’outils plus récents sont certes plus puissants, mais pas forcément plus marquants sur le plan affectif.

Une nostalgie très Internet

Il y a dans le regard porté sur Akinator une forme de nostalgie propre au web des années 2000. Une époque où l’on se laissait plus facilement surprendre par un service en ligne, où l’effet “waouh” ne dépendait pas encore de modèles géants, d’assistants omniprésents ou de promesses d’intelligence générale.

En ce sens, Akinator n’est pas seulement un jeu qui fatigue. C’est un symbole d’un Internet plus léger, plus ludique, parfois plus naïf aussi. Le revoir aujourd’hui moins performant provoque donc un petit choc : on ne perd pas juste un outil, on perd aussi un souvenir.

Faut-il enterrer Akinator ?

Pas forcément. Mais il faut sans doute accepter qu’il n’occupe plus la même place. Son intérêt est désormais autant patrimonial que fonctionnel. On peut encore le lancer par curiosité, pour le plaisir, ou pour revoir ce personnage qui a marqué le web francophone et au-delà.

En revanche, il serait difficile d’y voir encore une démonstration d’avant-garde. Le monde a changé, les attentes aussi. Aujourd’hui, un utilisateur attend :

  • des réponses plus naturelles ;
  • moins de répétitions ;
  • une meilleure tolérance aux descriptions imprécises ;
  • une interaction plus fluide ;
  • et surtout un résultat rapide et crédible.

Sur ce terrain, les outils d’IA modernes ont clairement redéfini les standards.

Un vieux génie qui mérite quand même le respect

Il est facile de se moquer d’un service qui accuse son âge. Ce serait pourtant oublier ce qu’a été Akinator : une expérience web immédiatement reconnaissable, populaire, accessible et vraiment bluffante pour son temps. Tout le monde ou presque a essayé un jour de le piéger.

Le voir perdre de sa superbe a quelque chose d’un peu triste, mais aussi de très logique. La technologie avance, les usages se déplacent, et les mythes numériques finissent eux aussi par vieillir. Reste une chose : si Akinator impressionne moins qu’avant, il garde une place à part dans la mémoire du web. Et ce n’est déjà pas si mal.

Source : https://www.lesnumeriques.com/societe-numerique/akinator-hommages-et-emotions-n253912.html

Classement IA mars 2026, le vainqueur est…

Le classement IA mars 2026 publié par le BDM montre une tendance qui se confirme : Anthropic reste très bien placé sur LMArena, devant Google, xAI et OpenAI. Si l’on suit un peu l’actualité des modèles, ce n’est pas vraiment une surprise, mais cela donne tout de même un bon instantané du marché vu par un benchmark collaboratif.

Anthropic garde la main sur le classement IA mars 2026

Les deux premières places sont occupées par Claude Opus 4.6, en version « thinking » puis en version standard. Derrière, on retrouve Gemini 3.1 Pro, puis Grok-4.20. Google place plusieurs modèles dans le top 10, tandis qu’OpenAI revient avec GPT-5.4 « high » et GPT-5.2 après avoir été plus discret ces derniers mois.

Le top 10 cité met en avant :

  • Claude Opus 4.6 « thinking »
  • Claude Opus 4.6
  • Gemini 3.1 Pro
  • Grok-4.20
  • Gemini 3 Pro
  • GPT-5.4 « high »
  • Grok-4.20 « reasoning »
  • GPT-5.2
  • Gemini 3 Flash
  • Claude Opus 4.5 « thinking »

Des leaders différents selon les usages

L’intérêt ici, c’est que LMArena ne se limite plus à un classement général. Par catégorie, les écarts deviennent plus parlants. En génération de texte et en développement web, Anthropic semble garder une avance nette. En analyse d’image, Google prend la main avec Gemini. Et en génération d’images, la source signale l’arrivée en tête de Nano Banana 2.

Autrement dit, parler du « meilleur modèle » n’a de sens que si l’on précise la tâche. C’est probablement le point le plus utile à retenir.

Ce qu’il faut en penser

Comme toujours avec LMArena, il faut garder en tête qu’il s’agit d’un benchmark fondé sur les votes des utilisateurs. C’est intéressant pour suivre la perception réelle des performances, mais ce n’est pas un verdict absolu. Malgré cela, la photographie de mars 2026 est claire : Anthropic domine encore la conversation, Google reste très solide, xAI progresse, et OpenAI n’a pas disparu du jeu.

À suivre donc, car sur ce marché, un classement tient parfois seulement jusqu’à la prochaine mise à jour.

Source : https://www.blogdumoderateur.com/top-20-modeles-ia-mars-2026-classement-complet/