Vous cherchez un livre de programmation, de maths ou simplement une idée de lecture qui sort des classements habituels ? HackerBooks rassemble les ouvrages évoqués sur Hacker News depuis 2007. L’intérêt n’est pas seulement de voir quels titres reviennent souvent : le site essaie aussi de distinguer un livre cité au détour d’une discussion d’un livre réellement conseillé. Et cette nuance change pas mal de choses.
HackerBooks transforme les discussions en bibliothèque
Les utilisateurs de Hacker News échangent depuis des années des recommandations dans les commentaires. Le problème, c’est qu’une bonne suggestion peut vite disparaître sous une pile de nouvelles discussions. HackerBooks remet de l’ordre dans tout ça : 15 766 livres ont été recensés à partir de 281 363 mentions publiées depuis 2007.
Pour figurer dans la bibliothèque, un ouvrage doit avoir été cité par au moins deux personnes différentes. Ce seuil ne garantit pas qu’il soit excellent, bien sûr, mais il évite de construire tout un catalogue sur des mentions isolées. On obtient ainsi un point d’entrée pratique pour retrouver des livres dont plusieurs personnes ont parlé.
Les ouvrages sont répartis dans des rubriques comme la programmation, les mathématiques, la philosophie ou la fiction. Chaque fiche permet aussi de revenir aux commentaires associés. C’est à mon avis la partie la plus utile : un titre seul donne une piste, une discussion aide à comprendre pourquoi il mérite votre temps.
Une citation n’est pas une recommandation
C’est le piège classique des classements fondés sur la popularité. Un livre peut être mentionné parce qu’il a marqué un domaine, parce qu’il suscite un désaccord ou simplement parce qu’il répond à une question précise. Compter toutes ces occurrences comme des recommandations donnerait une image trompeuse.
HackerBooks utilise l’IA pour séparer les citations des recommandations. Prenez The Art of Computer Programming, de Donald Knuth : 1 125 personnes l’ont cité, mais 336 l’ont recommandé. Le premier chiffre mesure sa présence dans les conversations ; le second tente de mesurer l’envie de le conseiller. Ce n’est pas du tout la même information.
Différence entre citations et recommandations de livres dans HackerBooks
J’aime bien cette distinction parce qu’elle pousse à regarder derrière les chiffres. Si vous cherchez votre prochaine lecture, un ouvrage très cité n’est pas automatiquement celui par lequel commencer. Il vaut mieux lire quelques commentaires pour voir à qui il s’adresse, ce que les lecteurs en ont retenu et dans quel contexte ils le proposent.
Comment trouver une lecture qui vous correspond ?
Une grosse bibliothèque peut rapidement devenir une nouvelle façon de perdre du temps. Le plus simple est de partir d’un besoin concret, puis de confronter les suggestions aux discussions. Par exemple :
Choisissez une rubrique liée à ce que vous voulez découvrir ou approfondir.
Repérez les livres recommandés, sans vous arrêter au nombre total de citations.
Ouvrez les commentaires pour comprendre les avis et le niveau attendu.
Comparez plusieurs titres avant de décider lequel vous donnera vraiment envie de lire.
Le site propose aussi des suggestions personnalisées en fonction des fiches ouvertes. Cela peut aider à prolonger l’exploration, surtout quand un ouvrage vous intrigue sans être exactement ce que vous cherchiez. Mais je garderais la main sur le choix final : une suggestion automatique connaît vos clics, pas forcément vos objectifs.
Une bonne idée, à utiliser avec un peu de recul
HackerBooks a été codé avec Claude à la demande de Roansh. Dans le même esprit, HackerTube rassemble des vidéos recommandées sur Hacker News. Je trouve ces projets intéressants parce qu’ils donnent une forme utilisable à des années d’échanges dispersés. L’IA sert ici à organiser et à trier, plutôt qu’à inventer une liste de lectures sortie de nulle part.
Il reste une précaution importante : le classement des recommandations repose sur une interprétation automatique. Le contexte d’un commentaire peut être subtil, et un livre peut être confondu avec un autre. Si une fiche vous semble étrange, les discussions restent le meilleur endroit pour vérifier ce que les personnes voulaient dire. Il est également possible de signaler une erreur au créateur du site.
Enfin, HackerBooks n’est pas une bibliothèque de fichiers à télécharger : les fiches orientent vers des vendeurs de livres. Son intérêt est ailleurs, dans la découverte et dans l’accès aux échanges autour des ouvrages. Si vous avez envie d’apprendre quelque chose de nouveau, c’est une bonne porte d’entrée. Reste ensuite le plus difficile : choisir un livre, le commencer et aller jusqu’au bout.
Le trunk-based development revient dans les discussions dès qu’on parle de code produit avec l’aide de l’IA. Puisque les modifications arrivent plus vite, pourquoi attendre une pull request, une revue et une fusion pour les intégrer ? Mais supprimer une étape ne supprime pas le travail qu’elle accomplissait. Il faut décider où placer ce travail, et comment vérifier qu’il est bien fait.
Je préfère une petite modification intégrée rapidement à une grosse pull request qui attend plusieurs jours. Pour autant, je ne donnerais pas les clés de la branche principale à toute l’équipe au seul motif qu’un assistant IA aide à écrire le code. La vitesse est utile si elle réduit aussi le délai entre une erreur et sa détection.
Trunk-based development : ce qu’on change vraiment
Le principe du trunk-based development consiste à intégrer fréquemment de petites modifications dans une branche principale commune. On évite ainsi que chacun travaille trop longtemps dans son coin, avec une branche qui diverge progressivement du reste du projet. Ce n’est pas forcément « plus de branches du tout » : des branches très courtes peuvent garder leur place.
La différence importante se situe dans la taille et la durée de vie du travail isolé. Une branche ouverte pour quelques heures et une pull request relue rapidement restent compatibles avec cette logique. À l’inverse, une fonctionnalité complète développée pendant des semaines avant fusion rend l’intégration plus risquée, même si elle passe par une revue formelle.
Le débat « pull requests ou trunk » devient trompeur quand il oppose deux boutons dans une interface Git. Une pull request est un moyen de discuter et de contrôler une modification. Le trunk-based development est une manière d’organiser le flux de travail.
Ce que l’IA accélère, et ce qu’elle ne vérifie pas
Un assistant peut proposer du code, des tests ou une première explication d’un changement. C’est pratique pour avancer. Mais une proposition rapide n’est pas automatiquement une modification pertinente. Il reste à vérifier qu’elle répond au besoin, s’intègre au projet et ne dégrade pas un comportement moins visible.
C’est là que je serais prudent avec l’idée de rendre les pull requests obsolètes. Si l’IA augmente le volume de code produit, elle peut aussi augmenter le volume de code à comprendre. Déplacer ce volume directement sur la branche principale, sans ajuster les contrôles, ne me semble pas être un progrès.
Avant d’intégrer une modification, je garderais au minimum quelques questions en tête :
Le changement est-il assez petit pour être compris et annulé facilement ?
Les tests vérifient-ils le comportement qui compte, et pas seulement le chemin le plus évident ?
Une personne connaît-elle la raison du changement, même si l’IA a participé à son écriture ?
Que se passe-t-il si cette modification casse quelque chose après l’intégration ?
Ces questions ne réclament pas nécessairement une longue revue asynchrone. Elles réclament en revanche une réponse. Selon les équipes, elle peut prendre la forme d’une revue courte, d’un échange en binôme, de contrôles automatisés ou d’une combinaison des trois.
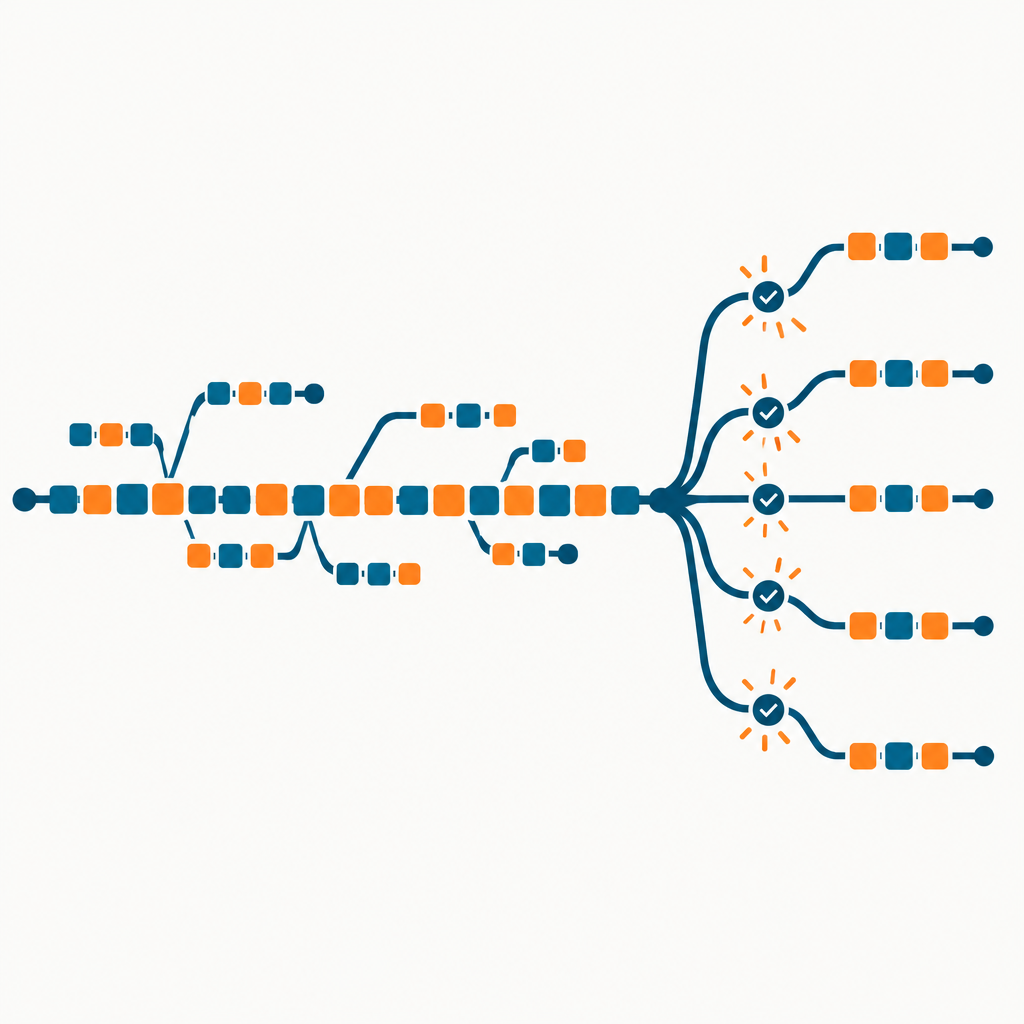
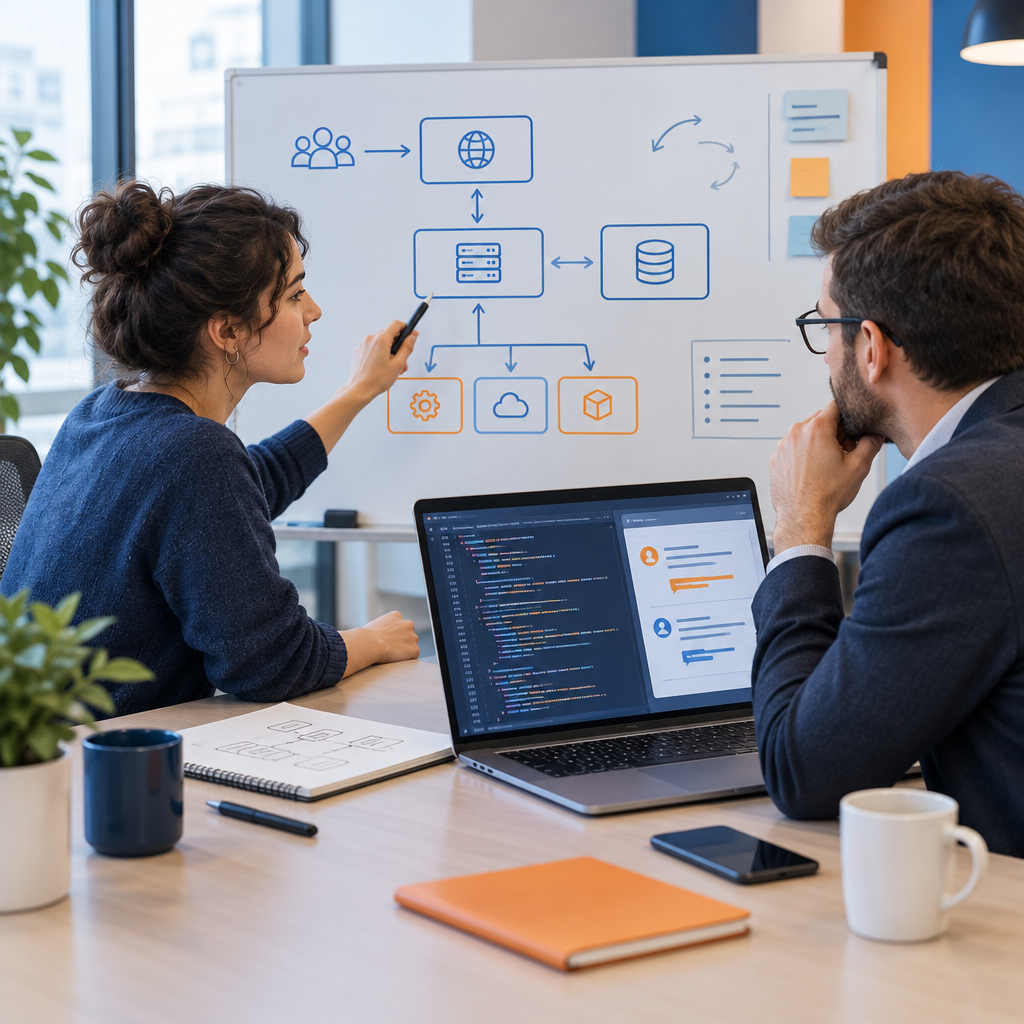
Comparaison visuelle entre branche longue et intégrations fréquentes sur le trunk
Des petits changements, pas des contrôles en moins
À mes yeux, le principal intérêt du trunk-based development n’est pas de gagner quelques clics dans Git. C’est de rendre chaque changement assez limité pour qu’on puisse le comprendre, le tester et, si besoin, revenir en arrière. La taille des modifications devient alors un outil de maîtrise du risque.
Prenons une fonctionnalité qui touche à la base de données, au traitement métier et à l’interface. Tout livrer d’un coup complique la revue comme le diagnostic en cas de problème. La découper en étapes cohérentes permet de vérifier chaque partie plus tôt. Mais il faut préparer ces étapes : un changement intermédiaire ne doit pas casser le fonctionnement existant.
Les feature flags peuvent aider à séparer l’intégration du code de l’activation d’une fonctionnalité. Le code rejoint la branche principale, tandis que la nouveauté reste désactivée pour les utilisateurs concernés jusqu’à ce qu’elle soit prête. Ce n’est pas une solution magique : les états activé et désactivé doivent être testés, et les flags devenus inutiles doivent être retirés.
Je retiens surtout une règle pratique : si une modification paraît impossible à intégrer sans tout terminer auparavant, il faut regarder si on peut la découper autrement. Ce n’est pas toujours facile, notamment lorsqu’une migration touche plusieurs composants. Mais cette difficulté mérite d’être traitée comme un problème de conception, pas cachée dans une branche de longue durée.
Ce qu’il faut préparer avant de changer de méthode
Intégrer plusieurs fois par jour suppose une branche principale sur laquelle l’équipe peut travailler sans appréhension. Pour y parvenir, il faut plus qu’une consigne du type « faites des petits commits ». Les tests doivent être utiles, leur résultat doit arriver assez vite, et un échec doit être pris en charge rapidement.
Je commencerais par observer le fonctionnement actuel plutôt que par interdire les pull requests. Combien de temps une modification attend-elle une revue ? Quelle taille font les changements difficiles à relire ? Quels tests échouent régulièrement sans signaler un vrai problème ? Ces questions montrent où le travail ralentit et où la confiance manque.
Ensuite, je ferais évoluer les habitudes progressivement :
Découper une tâche en changements plus petits, chacun avec un objectif compréhensible.
Automatiser les vérifications que l’équipe répète déjà à chaque revue.
Conserver une intervention humaine ciblée sur les choix de conception, les cas sensibles et les risques métier.
Prévoir comment désactiver une fonctionnalité ou revenir sur un changement problématique.
Vérifier régulièrement si le délai d’intégration baisse sans multiplier les incidents.
Ce dernier point est important. Une équipe peut fusionner beaucoup plus vite tout en passant davantage de temps à réparer. Elle n’a alors fait que déplacer l’attente : elle n’est plus devant la pull request, elle se retrouve après la mise en production.
Flux de vérification et d’intégration de petits changements de code
Faut-il vraiment supprimer les pull requests ?
Je ne le ferais pas par principe. Dans une petite équipe qui échange souvent, une revue rapide avant fusion peut rester légère et utile. Dans un projet ouvert aux contributions extérieures, la pull request offre aussi un espace clair pour expliquer le changement et en discuter. Et certains changements sensibles justifient un contrôle explicite avant d’atteindre la branche principale.
En revanche, une pull request qui reste ouverte longtemps parce que personne n’a le temps de la lire ne protège pas grand-chose. Elle accumule les conflits, retarde les retours et finit parfois par être validée dans l’urgence. Dans ce cas, la bonne réponse n’est pas nécessairement de supprimer les revues : c’est de réduire leur taille et de leur réserver une vraie place dans le travail de l’équipe.
L’IA rend cette discipline encore plus importante. Si produire une modification prend moins de temps, comprendre pourquoi elle existe et vérifier ses effets ne doit pas devenir une formalité. La responsabilité du code reste humaine, qu’il ait été écrit à la main ou suggéré par un outil.
Au fond, je ne choisirais pas entre « tout passe par une pull request » et « tout part directement sur le trunk ». Je chercherais le circuit le plus court qui permette encore de comprendre, tester et corriger chaque changement. C’est moins spectaculaire qu’une révolution des méthodes de développement, mais probablement plus utile au quotidien.
Le recrutement des développeurs repose souvent sur un exercice bien connu : résoudre un problème de programmation sous les yeux d’un recruteur. Mais que mesure encore ce test lorsqu’une IA peut le réussir mieux que la plupart des candidats ? Chez Anthropic, un responsable a choisi de le retirer des entretiens de son équipe. Ce n’est pas la fin des évaluations techniques, mais c’est un signal intéressant sur ce qu’elles doivent désormais vérifier.
Pourquoi Claude change le recrutement des développeurs
Felix Rieseberg, qui a dirigé le développement technique de Claude.ai et de l’application de bureau Claude Code, a supprimé un entretien de code du processus de recrutement de son équipe. Son raisonnement est simple : Claude réussit désormais si bien ce type d’exercice que le résultat ne lui apporte plus assez d’informations utiles sur les candidats.
Un test de programmation avait pourtant un intérêt. Il permettait d’observer comment une personne comprenait une consigne, décomposait un problème et avançait vers une solution. Ce n’était pas une mesure parfaite de ses capacités, mais cela donnait un aperçu de sa manière de travailler. Si l’exercice ressemble surtout à un défi court et prévisible, sa réussite devient moins révélatrice.
Attention à la portée de cette décision : un responsable retire un test pour son équipe. Anthropic n’a pas annoncé la disparition de toutes ses évaluations techniques. La question n’est pas de savoir s’il faut encore tester les développeurs, mais comment le faire utilement.
Un test de code confronté aux capacités de Claude pour le recrutement des développeurs
Des exercices de plus en plus difficiles à calibrer
Une autre équipe d’Anthropic a rencontré le même problème avec un test à réaliser à domicile. Son responsable, Tristan Hume, a constaté que Claude Opus 4 obtenait de meilleurs résultats que la majorité des candidats dans le temps prévu. Il a d’abord augmenté la difficulté de l’épreuve.
Puis Opus 4.5 a atteint le niveau des meilleurs candidats sur cette nouvelle version. Une troisième mouture a donc été conçue autour de problèmes plus inhabituels, proches de jeux de réflexion, que le modèle n’est pas parvenu à résoudre. Cette succession de changements montre à quel point un test peut perdre rapidement sa valeur si les outils disponibles progressent plus vite que l’exercice lui-même.
Rendre une épreuve toujours plus difficile n’est toutefois pas forcément la meilleure réponse. Un problème très éloigné du travail quotidien peut départager des candidats sans aider à savoir qui saura maintenir une application, comprendre un besoin ou collaborer avec une équipe. Le bon test doit rester lié au poste, pas devenir une compétition de casse-têtes.
Que faut-il vraiment évaluer chez un développeur ?
Écrire du code n’est qu’une partie du métier. Dans un projet réel, il faut aussi choisir entre plusieurs solutions, lire l’existant, repérer les risques et expliquer ses décisions. L’arrivée d’assistants capables de produire rapidement une première réponse donne davantage de poids à ces compétences.
Une évaluation technique peut, par exemple, chercher à observer :
la façon dont le candidat clarifie un besoin avant de développer ;
sa capacité à relire, tester et corriger une solution ;
les compromis qu’il fait entre simplicité, performance et maintenance ;
sa manière d’expliquer ce qu’il comprend et ce qu’il vérifierait.
Ces pistes ne rendent pas les tests infaillibles. Elles déplacent simplement l’attention du résultat brut vers le raisonnement et les choix. Un programme qui fonctionne ne suffit pas toujours à montrer comment il se comportera une fois intégré à un produit utilisé et maintenu par d’autres.
Évaluation des compétences d’un développeur lors d’une discussion technique
Interdire l’IA ou adapter les entretiens ?
Anthropic interdit aux candidats d’utiliser Claude pendant les entretiens et les tests à domicile, sauf indication contraire. Cette règle vise à savoir ce qu’une personne peut faire elle-même. Elle ne résout pourtant qu’une partie du problème : même sans aide pendant l’épreuve, un exercice devenu trop facile pour l’IA peut ne plus distinguer efficacement les candidats.
Les entreprises cherchent aussi à encadrer davantage leurs évaluations. Dans une enquête menée auprès de 1 500 employeurs, 62,5 % des entreprises du secteur de l’information déclaraient demander des tests formels de compétences dès la candidature initiale. Environ 70 % avaient modifié leurs modalités, notamment avec des sessions surveillées ou en présentiel, pour limiter l’usage de l’IA.
La surveillance permet de fixer une règle claire, mais elle ne dispense pas de se demander ce que le test mesure réellement. À l’inverse, autoriser l’IA peut avoir du sens si l’objectif est d’observer comment un candidat utilise un outil, contrôle ses réponses et garde la maîtrise du résultat. Les deux approches répondent à des questions différentes.
Le test de code n’est pas mort, son objectif doit être clair
Claude ne rend pas les compétences des développeurs inutiles. Il remet en cause certains raccourcis utilisés pour les évaluer. Un petit exercice réussi rapidement ne dit pas nécessairement qui saura résoudre les problèmes d’une équipe sur la durée.
Pour les recruteurs, l’enjeu est de concevoir des épreuves proches du travail attendu et d’expliquer la place autorisée à l’IA. Pour les candidats, il reste essentiel de pratiquer, de comprendre leur code et de pouvoir défendre leurs choix. Les outils évoluent ; la capacité à bien poser un problème et à juger une solution reste, elle, au cœur du métier.
Sécuriser le Wi‑Fi en entreprise, ce n’est pas “juste” changer un mot de passe. C’est un ensemble de réflexes côté utilisateurs, de réglages côté infrastructure et de choix techniques cohérents. L’ANSSI vient de publier un guide pratique pour réduire les risques de piratage sur les réseaux sans fil professionnels.
Trois volets : salariés, réseau maîtrisé, administration des points d’accès
Le document de l’ANSSI s’organise autour de trois axes. D’abord, les habitudes des salariés : ce sont souvent elles qui ouvrent la porte aux incidents. Ensuite, le principe de base : ne se connecter qu’à des réseaux maîtrisés par l’entreprise. Enfin, l’administration sécurisée des points d’accès, avec des réglages précis.
L’idée est simple : si vous sécurisez le Wi‑Fi “sur le papier” mais que les usages réels contournent les règles, le risque reste entier. Le guide insiste donc sur l’alignement entre politique interne et configuration technique.
Les bons réflexes côté utilisateurs (ce qui évite la majorité des galères)
Pour les usages quotidiens, l’ANSSI recommande plusieurs actions concrètes. L’objectif : limiter l’exposition quand un employé est en mobilité ou utilise son ordinateur portable en dehors du périmètre habituel.
Couper l’interface Wi‑Fi et le partage de connexion quand ils ne servent pas.
Désactiver la connexion automatique aux réseaux déjà mémorisés.
Ne se brancher que sur des réseaux réellement maîtrisés (ceux que l’entreprise contrôle).
Si vous ne pouvez pas éviter un hotspot public : utiliser le VPN de l’entreprise.
Autre point très pragmatique : configurer le pare-feu local des ordinateurs portables pour bloquer les connexions entrantes, notamment via le Wi‑Fi. Enfin, avant de reconditionner, céder ou mettre au rebut
un appareil professionnel, il faut effacer les réseaux enregistrés et les mots de passe associés. Sinon, vous laissez des accès réutilisables “hors contrôle”.
Changements indispensables sur l’infrastructure : WPS, UPnP et réseaux invités
Sur le plan infrastructure, l’ANSSI est claire : certains mécanismes doivent être désactivés par défaut, car ils augmentent la surface d’attaque.
Désactiver WPS sur les points d’accès.
Désactiver UPnP si personne ne l’utilise.
Interdire l’usage d’un hotspot personnel au bureau.
Bloquer par défaut les terminaux non maîtrisés (ex. téléphones personnels), et n’ouvrir qu’un réseau Wi‑Fi invité dédié et cloisonné.
Le cloisonnement n’est pas un détail : il sert à empêcher qu’un appareil “invité” ou moins contrôlé puisse interagir avec le reste du système d’information. En pratique, vous séparez les chemins de communication et vous réduisez les conséquences d’un incident.
Le chiffrement : WPA3 en priorité, et des conditions strictes pour WPA2
Le guide rappelle que le chiffrement reste un pilier. L’ANSSI pousse vers des protocoles robustes, en particulier WPA3‑Enterprise, WPA2‑Enterprise sous conditions, ou WPA3‑Personal.
En WPA3‑Enterprise, l’ANSSI recommande des suites EAP compatibles avec une authentification par certificats. Et surtout : il faut vérifier la validité des certificats avant chaque connexion.
En WPA2‑Enterprise, le choix dépend de conditions précises. L’important, c’est la logique : plus l’authentification est forte et contrôlée, moins le réseau est vulnérable aux contournements.
Un plan d’action simple pour sécuriser le Wi‑Fi en entreprise
Si vous devez passer à l’action, vous pouvez structurer votre démarche en trois étapes. L’objectif n’est pas de tout faire d’un coup, mais de traiter les points qui réduisent le risque le plus vite.
Cartographier les usages : où les salariés se connectent-ils réellement ? Quels réseaux sont “mémorisés” ? Qui utilise le Wi‑Fi invité ?
Durcir la configuration : désactiver WPS, désactiver UPnP si inutile, bloquer les terminaux non maîtrisés, mettre en place un Wi‑Fi invité cloisonné.
Renforcer l’authentification et le chiffrement : viser WPA3‑Enterprise, et encadrer strictement les déploiements WPA2‑Enterprise.
Ajoutez à cela une règle d’hygiène : quand un poste change de propriétaire ou de statut, on efface les réseaux et identifiants enregistrés. Ce point est souvent oublié, alors qu’il est directement lié à la prévention des réutilisations non autorisées.
Pourquoi ces recommandations sont “plus que jamais utiles”
Le Wi‑Fi est devenu un point d’entrée naturel : il est pratique, omniprésent, et parfois utilisé sans réfléchir aux conséquences. Le guide de l’ANSSI remet les priorités au bon endroit : réduire les connexions non maîtrisées, durcir l’infrastructure et choisir des mécanismes de chiffrement et d’authentification solides.
En bref : sécuriser le Wi‑Fi en entreprise, c’est aligner les comportements et les paramètres techniques. Et c’est précisément ce que ce type de recommandations rend possible.
Prochaine étape : faites un audit rapide de vos points d’accès (WPS/UPnP, segmentation invité) puis vérifiez vos règles d’usage (VPN, désactivation de la connexion automatique, pare-feu). Vous gagnerez en sécurité sans complexifier inutilement le quotidien.
WizTree répond enfin à la question que Windows esquive quand votre disque se remplit : “qu’est-ce qui prend toute la place ?”. Là où l’outil de stockage de Windows vous laisse face à une catégorie fourre-tout, WizTree pointe les coupables avec une rapidité impressionnante.
Concrètement, si vous avez déjà vu votre espace disparaître au fil des caches, des vidéos oubliées et des dossiers de projets jamais purgés, vous allez comprendre pourquoi “Autres” devient vite frustrant. WizTree, lui, vous montre le fichier précis et vous permet d’agir.
Pourquoi Windows vous cache la vérité (“Autres”)
Sur un PC Windows, l’espace disque ne s’évapore pas “magiquement”. Il se déplace : fichiers temporaires, téléchargements qui s’accumulent, rushs vidéo, archives, doublons… Le problème, c’est que Windows regroupe souvent ces éléments dans une catégorie vague, “Autres”. Résultat : vous savez que ça prend de la place, mais vous ne savez pas quoi supprimer.
WizTree change la donne. Il lit directement l’index central du système de fichiers, ce qui lui permet de cartographier le disque sans passer par une longue tournée dossier par dossier.
Le principe de WizTree : lire l’index NTFS, pas parcourir tout
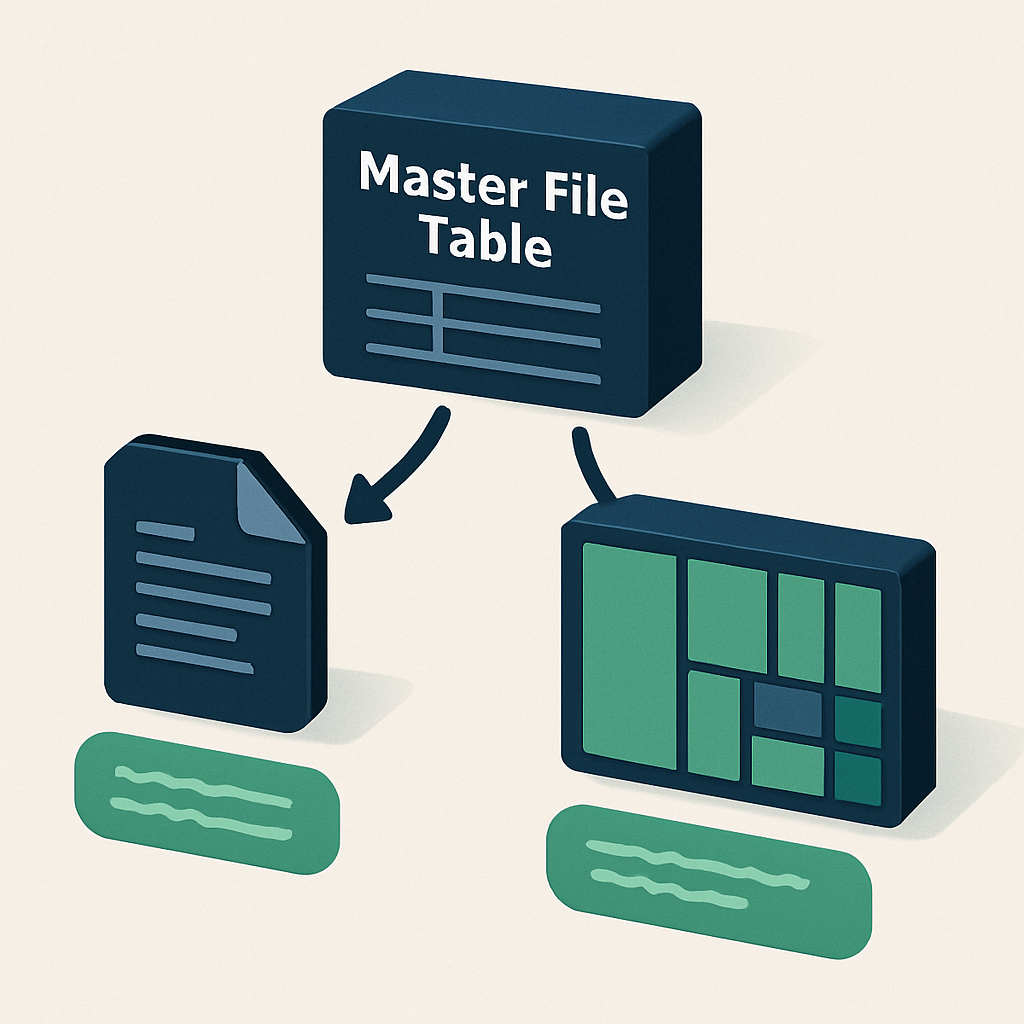
Sur un volume NTFS, chaque fichier est référencé dans la Master File Table (MFT), l’index que Windows maintient en continu. La plupart des analyseurs classiques explorent l’arborescence en parcourant les dossiers. WizTree, lui, exploite la MFT : il “lit l’inventaire” au lieu de faire le tour des pièces.
Le résultat se ressent immédiatement : sur des disques de plusieurs téraoctets, l’analyse peut arriver très vite, là où un scan classique peut prendre des minutes.
Schéma pédagogique de la lecture de l’index NTFS (MFT) vers la liste des fichiers lourds
Ce que WizTree affiche vraiment (et pourquoi c’est utile)
WizTree ne se contente pas de dire “ça fait X Go”. Son interface vous aide à diagnostiquer et prioriser.
Arborescence par taille : vous descendez du gros au détail, jusqu’au fichier individuel.
Treemap : chaque fichier devient un rectangle proportionnel à son poids. Les gros éléments ressortent visuellement, sans effort.
Vue par extensions : pratique pour repérer rapidement des masses entières (par exemple des images ISO, des archives, des vidéos, etc.).
Recherche et tri : pour retrouver un nom, classer par taille, et accélérer le ménage.
Détection de doublons : WizTree repère les fichiers en double, ce qui évite de supprimer “à l’aveugle”.
Autre point pratique : vous pouvez relancer l’analyse sur un dossier précis, un disque entier ou l’ensemble des volumes montés. Et il existe aussi une version portable, utile quand vous dépannez un PC familial sans vouloir installer quoi que ce soit.
Treemap, doublons et gros fichiers : la différence avec les outils classiques
Les outils historiques du genre (comme WinDirStat ou TreeSize) restent utiles, mais leur méthode de parcours dossier par dossier peut pénaliser sur les gros volumes. WizTree adopte une approche plus directe et, surtout, rend l’information plus actionnable.
Quand vous cherchez “ce qui remplit”, vous n’avez pas besoin d’un rapport abstrait. Vous avez besoin de chemins, de tailles, et d’une vue qui vous fait comprendre en quelques secondes où agir. La treemap et la liste des fichiers lourds font exactement ce travail.
Et si votre problème vient de doublons, WizTree vous donne un levier immédiat : vous identifiez les répétitions, puis vous passez à l’étape suivante (par exemple avec un outil dédié au ménage de doublons).
Treemap WizTree mettant en évidence les gros fichiers responsables de l’espace disque manquant
Les limites à connaître avant de lancer WizTree
WizTree est particulièrement efficace sur les volumes NTFS, car son approche repose sur la lecture de l’index associé. Si vous utilisez un support en exFAT ou un lecteur réseau, WizTree repasse par un scan plus “classique”, donc potentiellement plus lent.
Autre réflexe utile : avant d’acheter un SSD plus grand, vérifiez si la place existe déjà… mais qu’elle est simplement mal rangée. Dans beaucoup de cas, le “manque” vient d’un stockage dispersé : des archives, des caches, des médias et des projets qui n’ont jamais été consolidés.
Mon conseil : une méthode simple pour reprendre la main
Pour que WizTree serve vraiment à quelque chose, je vous recommande une démarche en trois temps :
Repérez les 10 plus gros éléments (treemap + tri par taille). Ne cherchez pas tout : commencez par l’impact.
Contrôlez les doublons avant de supprimer. Si vous supprimez sans vérifier, vous risquez de casser un projet ou de perdre un fichier “utile”.
Nettoyez par catégories : archives, médias, caches, téléchargements. Une fois le gros fait, le reste devient facile.
Vous verrez alors disparaître la frustration du “Autres” : vous saurez enfin ce qui prend la place, et vous pourrez décider quoi garder, quoi déplacer, et quoi supprimer.
Conclusion : WizTree rend l’espace disque compréhensible
WizTree ne fait pas que “montrer” : il explique et oriente. En affichant rapidement les fichiers responsables, il transforme un problème flou (“mon disque est plein”) en actions concrètes (où regarder, quoi trier, quoi supprimer).
Et si vous avez déjà vécu cette scène où Windows vous répond “Autres”, vous savez : la meilleure victoire, c’est de retrouver de la clarté. La prochaine étape, c’est d’instaurer un petit rituel de ménage pour éviter que “Autres” ne revienne trop vite.
Jellyfin est un pilier de l’auto-hébergement multimédia : gratuit, libre, et porté par une communauté. Mais en juillet 2026, le projet a perdu trois de ses visages les plus anciens en seulement quatre jours. Pour les utilisateurs, ce n’est pas un simple fait divers : c’est un signal à prendre au sérieux, sans paniquer.
Ce qui s’est passé, concrètement
D’après les informations disponibles, deux cofondateurs et un chef de projet ont annoncé leur départ sur le forum officiel, avec des dates rapprochées. Le premier départ remonte au 17 juillet, puis deux autres annonces suivent trois jours plus tard. Les raisons évoquées ne sont pas identiques : épuisement, priorités personnelles, et une friction liée à la manière de travailler.
Ce point est important : quand plusieurs personnes clés quittent un projet, ce n’est pas forcément un “drame technique”. Cela peut aussi refléter une fatigue humaine, un changement de cap, ou des désaccords de méthode. Dans tous les cas, l’utilisateur doit regarder au-delà de l’événement et évaluer la continuité.
Départs de mainteneurs et continuité d’un projet libre
Pourquoi ces départs comptent pour les utilisateurs
Un serveur multimédia comme Jellyfin dépend de plusieurs couches : le code, la maintenance, la documentation, et l’écosystème des clients (web, mobile, TV). Quand des profils historiques partent, la question devient : qui assure le quotidien et la trajectoire du projet ?
Trois impacts potentiels reviennent souvent dans ce type de situation :
Rythme de développement : moins de contributions sur certaines fonctionnalités, le temps que la coordination se stabilise.
Priorités : certaines améliorations peuvent être replanifiées, d’autres accélérées selon les nouveaux contributeurs.
Risque de fragmentation : même si ce risque n’est pas automatique, il existe toujours quand la gouvernance change.
À ce stade, l’élément rassurant est que la passation est présentée comme amicale et que l’équipe en place continue d’assurer l’essentiel. Mais “rassurant” ne veut pas dire “inutile de se préparer”.
Le contexte : l’auto-hébergement multimédia n’est pas figé
Le duel Plex/Jellyfin a longtemps structuré le paysage : Plex s’appuie sur une logique d’abonnement, tandis que Jellyfin revendique une approche libre et communautaire. Historiquement, ce modèle attire des contributeurs… mais il expose aussi le projet à une réalité : la disponibilité des bénévoles n’est pas garantie dans le temps.
Le texte source évoque aussi un précédent marquant dans le monde des serveurs multimédia : des bascules de code vers du fermé peuvent survenir, et elles changent la confiance des utilisateurs. Autrement dit, la meilleure stratégie n’est pas d’espérer que “ça ira toujours”, mais de réduire sa dépendance à un seul point de fragilité.
Comment évaluer le risque pour votre installation Jellyfin
Si vous utilisez Jellyfin en production personnelle (famille, maison, ou usage régulier), vous pouvez adopter une grille simple. L’idée : repérer tôt si la maintenance se dégrade.
Regardez l’activité récente : commits, issues, réponses sur le forum, fréquence des corrections.
Surveillez les releases : des mises à jour régulières indiquent une capacité de maintenance.
Vérifiez la stabilité des clients : web, mobile et TV doivent rester compatibles avec le serveur.
Testez avant de mettre à jour : idéalement sur une instance de préproduction ou un environnement de test.
Gardez une stratégie de repli : sauvegardes, export de configuration, et connaissance des alternatives.
Ces actions ne demandent pas d’être développeur. Elles demandent surtout de la méthode.
Checklist de bonnes pratiques pour sécuriser un serveur multimédia
Bonnes pratiques pour sécuriser votre auto-hébergement
Au-delà de Jellyfin lui-même, l’enjeu est votre continuité de service. Voici des pratiques qui réduisent l’impact d’un changement de mainteneur, d’une rupture de rythme ou d’un bug :
Sauvegardez : configuration, base de données si applicable, et fichiers de médias (au moins via une stratégie de copie).
Documentez : comment vous déployez Jellyfin, vos paramètres réseau, vos intégrations (reverse proxy, authentification, etc.).
Isoler les dépendances : reverse proxy et certificats gérés proprement, pour éviter que tout casse en cascade.
Planifiez les mises à jour : une fenêtre de maintenance, même courte, vaut mieux qu’une mise à jour “au fil de l’eau”.
Gardez un œil sur la communauté : forums, discussions, et retours d’utilisateurs donnent souvent une image plus fiable que les annonces seules.
Le but n’est pas de “se préparer au pire”. Le but est de rester maître de votre installation.
Faut-il quitter Jellyfin ?
À mon avis, non : quitter un outil ne se décide pas sur un épisode de départs, mais sur une observation de la trajectoire. Les annonces évoquent une passation et une continuité, ce qui est déjà un signal positif.
En revanche, je recommande de passer en mode “gestion du risque” : vérifiez l’activité, gardez vos sauvegardes, et testez vos mises à jour. Si vous constatez une baisse durable de maintenance ou des signaux de fragmentation, alors seulement il faudra envisager une alternative.
Conclusion : continuité d’abord, vigilance ensuite
La perte de figures historiques de Jellyfin rappelle une évidence : un projet libre vit au rythme des personnes qui le portent. Pour les utilisateurs, la bonne réponse n’est ni la panique ni l’indifférence, mais une vigilance structurée.
La suite dira si la communauté absorbe bien ces départs et maintient la dynamique. En attendant, gardez votre installation sous contrôle : sauvegardes, tests, et suivi de l’activité.
Le Home Assistant de Korben a connu un cycle classique : ça marche, puis ça se dégrade, puis ça finit par lasser. Cette fois, il a changé deux choses clés : la machine (mini PC sur SSD au lieu de Raspberry Pi sur carte SD) et la façon de créer les automatisations (avec une IA qui parle en français). Résultat : moins de pannes, plus de scénarios, et surtout un système qui tient mieux dans la durée.
Pourquoi Korben a décroché (et ce qui l’a relancé)
Dans son retour, Korben explique qu’il aime l’idée des automatisations, mais que l’expérience précédente était frustrante. Les Raspberry Pi finissaient par corrompre les cartes SD, ce qui entraînait des arrêts et des redémarrages à répétition. À cela s’ajoutait un autre frein : le temps nécessaire pour régler des scénarios “au poil de cul”.
Le déclic arrive avec un contexte favorable : déménagement, cartons à vider, réinstallation du matériel, et surtout un mini PC disponible. Korben a aussi un angle “nouveautés” : l’arrivée de l’IA dans son quotidien et l’usage d’Alexa, qui rendent la domotique plus facile à intégrer dans ses habitudes.
Mini PC dédié pour faire tourner Home Assistant de façon fiable
Étape 1 : le mini PC sur SSD, le vrai changement de fond
Le point de départ, c’est un mini PC NiPoGi Pinova P1 (Ryzen 3 4300U, 16 Go de RAM, 1 To de SSD) que Korben avait acheté en 2023. Il le décrit comme surdimensionné pour la domotique… et c’est justement pour ça que c’est un bon choix : la domotique n’a pas besoin de puissance, elle a besoin de fiabilité.
Le problème historique de ses installations, c’était le stockage : une carte SD qui “rend l’âme” après quelques mois d’écritures permanentes. En passant sur un SSD, Korben supprime la cause la plus fréquente de ses arrêts. Ce n’est pas spectaculaire, mais c’est exactement le genre de détail qui change tout.
Home Assistant OS : moins d’administration, plus de sérénité
Korben installe Home Assistant OS sur la machine. Son intérêt est clair : HAOS agit comme un système dédié, sans Linux à administrer en dessous et sans Docker à maintenir. Il y retrouve aussi le magasin d’add-ons et les sauvegardes automatiques, ce qui réduit la charge mentale.
Pour lui, sur une machine dédiée, c’est “le mode le plus tranquille”. Et quand on a déjà vécu des pannes, la tranquillité devient une fonctionnalité à part entière.
Les deux pièges à connaître avant de démarrer
Dans son retour, Korben insiste sur des points qui peuvent faire perdre du temps :
BIOS/boot : HAOS exige le mode UEFI activé et le Secure Boot désactivé. Sinon, la clé USB ne boote pas.
Redémarrage après coupure : il faut régler “Restore on AC Power Loss / After Power Failure / AC Back Function” sur Power On. Sinon, une micro-coupure peut laisser la maison sans domotique jusqu’à une action manuelle.
Ce deuxième point est particulièrement parlant : Korben explique qu’en vacances, on n’a pas envie de dépendre d’un bouton à distance.
Étape 2 : brancher l’IA pour créer des automatisations sans YAML
Une fois le socle stable, Korben s’attaque au sujet qui le freinait : créer des scénarios rapidement, sans passer des heures à écrire et ajuster du YAML. Son approche repose sur Claude Code connecté à Home Assistant via un serveur MCP.
Le résultat qu’il décrit est concret : il crée 21 automatisations en quelques jours en décrivant ses besoins en français, sans écrire de YAML. L’objectif n’est pas de “remplacer” la domotique, mais de réduire le coût d’entrée pour produire des scénarios fonctionnels.
Ce que Korben gagne avec cette méthode
Vitesse : passer de l’idée au scénario sans friction technique.
Itération : ajuster plus facilement quand un comportement ne correspond pas exactement à l’attendu.
Focus : moins de temps sur la syntaxe, plus de temps sur la logique métier (présence, sécurité, confort).
Dans son retour, on sent surtout un changement d’énergie : la domotique redevient un projet “plaisir” plutôt qu’un chantier de correction permanent.
Capteur mmWave de présence et logique de garde-fou pour éviter les faux positifs
Étape 3 : capteur mmWave et garde-fous contre les faux positifs
Korben ajoute un capteur mmWave (Moes) pour détecter la présence. Son point de vue est nuancé : il détecte une présence statique, contrairement à des PIR classiques qui réagissent surtout au mouvement.
Mais il ne vend pas ça comme une baguette magique. Il explique que le capteur peut se “verrouiller” sur des échos fantômes, ce qui peut provoquer des faux positifs. Et c’est là que son approche devient intéressante : il ne cherche pas à “forcer” le capteur, il cherche à sécuriser le système autour de lui.
Le principe : automatisation de garde-fou
Son retour insiste sur une idée simple : quand un capteur peut se tromper, il faut prévoir un comportement de secours. Autrement dit, une logique de garde-fou évite qu’une détection erronée déclenche des actions indésirables.
Ce point est typique des installations qui tiennent dans le temps : on ne supprime pas l’imperfection du monde réel, on la contient.
Ce que Korben retient : fiabilité d’abord, puis productivité
En filigrane, le retour de Korben raconte une progression. D’abord, il remet la domotique sur des bases fiables (SSD + HAOS + redémarrage après coupure). Ensuite, il accélère la création de scénarios avec l’IA, pour ne plus subir la partie la plus pénible. Enfin, il traite les capteurs “imparfaits” avec des garde-fous, au lieu de chercher la perfection.
Checklist “retour d’expérience” (pratique)
Pour résumer son approche, voici les points qui ressortent le plus :
Éviter la fragilité du stockage : si des cartes SD meurent chez vous, passez sur un SSD.
Valider le BIOS : UEFI activé, Secure Boot désactivé.
Gérer le retour après coupure : “Power On” pour éviter une maison muette au prochain incident.
Accélérer les scénarios : utilisez l’IA pour décrire vos besoins en langage naturel et réduire le coût de production.
Prévoir des garde-fous : surtout avec des capteurs capables d’erreurs (échos, verrouillages, etc.).
Conclusion : une domotique qui tient, parce qu’elle est pensée comme un système
Le retour de Korben n’est pas une promesse “magique” : c’est une méthode. Il repart d’un constat (pannes et lenteur), puis il corrige les causes (stockage, démarrage, automatisations), et enfin il accepte la réalité des capteurs en ajoutant des protections.
Si vous voulez relancer votre Home Assistant sans retomber dans le même cycle d’abandon, la leçon la plus forte est peut-être celle-ci : la domotique n’est pas un gadget, c’est une infrastructure. Et une infrastructure se conçoit pour durer.
Ouverture : Une fois le socle stable, le prochain gain vient souvent de la qualité des scénarios (et de la manière de les itérer), plus que de l’ajout de matériel.
Januscape OVHcloud a mis en lumière un scénario que tout hébergeur redoute : une faille exploitable pouvant faire planter l’hôte physique. Quand l’attaque vise l’infrastructure elle-même, la question n’est plus “si” on corrige, mais “comment” on corrige vite, à grande échelle, sans multiplier les dégâts. OVHcloud a publié un retour d’expérience détaillé : chronologie, arbitrages et choix opérationnels, jusqu’aux ratés.
Le contexte : une faille qui touche l’hôte physique
La faille Januscape a été révélée comme un problème où une machine virtuelle louée peut provoquer le plantage du serveur physique qui l’héberge. Pour un acteur disposant de dizaines de milliers d’hôtes et d’environ un million de machines virtuelles, cela change la nature de l’urgence : il ne s’agit pas seulement de corriger des services, mais de sécuriser la plateforme d’exécution elle-même.
Dans son billet, OVHcloud explique avoir dû répondre à une double contrainte : agir rapidement, tout en tenant compte du fait que l’impact d’un correctif peut se traduire par des redémarrages et des effets de bord sur certains environnements.
Carte du monde illustrant le déploiement par relais horaire
11 jours pour patcher : la chronologie d’une réponse
OVHcloud décrit une opération structurée en étapes très courtes, avec des validations internes et des décisions prises au fil de l’eau. L’alerte tombe le 7 juillet en début d’après-midi. Le correctif est adapté aux noyaux Debian maison dans la journée, puis validé en laboratoire le soir.
Le point clé : l’équipe teste le comportement de l’exploit dans un cadre interne, et constate un plantage d’un hôte non corrigé en quelques minutes. Cette validation sert de base au feu vert décisionnel.
Le “follow the sun” pour enchaîner les régions
Le déploiement démarre depuis Sydney, un choix présenté comme moins “exotique” qu’il n’y paraît : la région est petite et sa nuit locale correspond aux heures de travail des équipes européennes. Une fois la procédure validée en conditions réelles, OVHcloud enclenche une logique de relais : chaque région prend le relais sur sa matinée locale, en continu.
Des seuils d’arrêt pour éviter l’emballement
Pour piloter le rythme, l’entreprise encadre l’opération avec des seuils. Par exemple, si le nombre d’hôtes en panne simultanée dépasse un certain niveau dans les régions les plus denses (et un niveau différent ailleurs), la vague est suspendue le temps que les techniciens de datacenter interviennent.
Sur la première nuit, OVHcloud indique que 20 à 30 hôtes sur 6 000 ne sont pas revenus seuls, avec des causes évoquées comme des barrettes mémoire ou des problèmes de configuration.
Le choix le plus lourd : corriger puis redémarrer
OVHcloud explique qu’il existait plusieurs options sur la table : attendre un correctif “officiel” via des noyaux, passer par un correctif à chaud, ou encore migrer massivement les machines virtuelles. Toutes sont écartées au profit d’une approche jugée la plus radicale : corriger puis redémarrer l’intégralité des hôtes.
Cette stratégie repose sur une idée simple : si la faille peut conduire à des plantages, alors la correction doit atteindre le niveau le plus fondamental de l’infrastructure, même si cela implique un impact opérationnel.
Orchestration de correctifs et redémarrages sur des hôtes de datacenter
“Patching unilatéral à impact contrôlé” : sans fenêtre de maintenance client
Le billet assume un point sensible : pas de fenêtre de maintenance négociée client par client. OVHcloud parle d’un patching unilatéral à impact contrôlé : les redémarrages sont appliqués sans accord individuel, et l’impact est considéré comme inévitable, à condition d’être maîtrisé.
Pour limiter la casse, l’entreprise met en place une logique d’orchestration basée sur un graphe de colocalisation. L’objectif est de ne pas redémarrer en même temps deux hôtes portant des instances d’un même projet client.
Anti-affinité “best effort” : pas de garantie absolue
OVHcloud revendique une anti-affinité en “best effort”, c’est-à-dire une approche qui réduit le risque sans pouvoir garantir un résultat parfait dans tous les cas. Concrètement, cela signifie que l’orchestration cherche à éviter les situations les plus dommageables, mais qu’elle ne peut pas éliminer toute possibilité de collision.
Les charges critiques : migration à chaud au cas par cas
Les charges les plus sensibles, notamment des machines virtuelles de bases de données managées, sont traitées autrement : OVHcloud indique avoir migré ces éléments à chaud, une par une. L’idée est de préserver la continuité là où elle est la plus difficile à obtenir via un simple redémarrage.
La communication : assumer, documenter… et gérer le silence initial
Dans son retour d’expérience, OVHcloud aborde aussi la dimension communication. L’entreprise explique avoir choisi de ne pas publier immédiatement une page d’état publique, afin de ne pas exposer certains détails susceptibles d’être utilisés.
Ce choix illustre un dilemme classique en cybersécurité : informer tôt peut aider les clients à se préparer, mais cela peut aussi fournir des repères à des acteurs malveillants. OVHcloud semble avoir privilégié la réduction du risque pendant la phase la plus critique.
Ce qu’on peut retenir : une méthode réplicable pour les crises de patch
Au-delà du cas Januscape, le retour d’expérience met en avant des principes opérationnels utiles quand une faille touche l’infrastructure :
Valider vite : adapter le correctif et tester l’impact en laboratoire avant d’industrialiser.
Choisir une stratégie “niveau infrastructure” quand la faille est structurelle (ici, redémarrer après correction).
Orchestrer le risque : anti-affinité et logique de colocalisation pour limiter les effets simultanés.
Rythmer avec des garde-fous : seuils d’arrêt et interventions datacenter planifiées.
Traiter les charges critiques différemment : migration à chaud quand c’est nécessaire.
Conclusion : la sécurité, c’est aussi de la décision sous contrainte
Januscape OVHcloud n’est pas seulement une histoire de correctif. C’est une histoire de décisions : quand corriger, comment redémarrer, comment limiter l’impact, et comment communiquer sans augmenter le risque. Le message implicite est clair : en cybersécurité, la vitesse compte, mais la méthode compte tout autant.
La prochaine question, pour les équipes techniques comme pour les clients, est simple : comment préparer à l’avance des plans de patch “à grande échelle” pour que l’urgence ne devienne pas une improvisation ?
Quand on se lance dans le self-hosting, on finit toujours par taper la même commande : ssh-keygen, Entrée trois fois, et hop… ça marche. Sauf que tes clés SSH ne sont pas un détail : ce sont littéralement les clés d’accès à tes serveurs. Et si tu les fabriques ou les organises mal, tu passes très vite de « un fichier volé » à « un accès permanent à tout ton parc ».
Dans ce guide, je te donne la méthode que j’applique sur mon homelab : bon format, bonne commande, passphrase obligatoire, organisation par usages, et ssh-agent bien configuré. Pas de théorie inutile : juste des décisions concrètes qui réduisent le risque.
1) Le bon format en 2026 : Ed25519, point
Si tu ne dois retenir qu’une chose : génère tes clés en Ed25519. La commande minimale est :
ssh-keygen -t ed25519
Pourquoi je pousse Ed25519 ? Parce que c’est un choix moderne, efficace et robuste dans l’écosystème OpenSSH. Et surtout : c’est le format que tu veux standardiser dans ton homelab, pour éviter les exceptions et les “ça marche chez moi” qui finissent par coûter cher.
Ce que tu évites
DSA : obsolète, à oublier.
ECDSA : acceptable en théorie, mais je préfère éviter les compromis et rester sur Ed25519.
RSA : utile uniquement pour l’interop avec un vieux système. Sinon, tu perds du temps à gérer un héritage.
Commande ssh-keygen en Ed25519 avec indicateurs de sécurité
2) La commande idéale, décortiquée
Voici la ligne que j’utilise et que je te recommande d’adopter comme standard :
ssh-keygen -t ed25519 -a 100 -C "moi@mon-pc" -f ~/.ssh/id_ed25519_mon_pc
Chaque option a un rôle. Et c’est précisément là que beaucoup de gens “génèrent n’importe comment” : ils laissent des valeurs par défaut sans comprendre ce qu’elles protègent.
-t ed25519 : le type de clé
On l’a vu : c’est ton standard. Pas de débat.
-a 100 : le blindage du fichier au repos
Ta clé privée n’est pas stockée en clair si tu mets une passphrase. Elle est chiffrée, et -a règle le coût de dérivation de la clé de chiffrement (KDF). Plus tu augmentes ce coût, plus un attaquant qui vole le fichier doit “payer” du temps pour tester des passphrases.
En pratique, 100 est un bon compromis : tu ne le sens presque pas à l’usage (une fois au déverrouillage), mais tu rends les essais beaucoup plus coûteux pour un attaquant.
Point important :-a ne sert à rien si tu ne mets pas de passphrase. Donc on enchaîne.
-C : un commentaire utile
Le commentaire (moi@mon-pc) n’ajoute pas de sécurité cryptographique. Mais il te sauve la vie quand tu retrouves une clé dans un authorized_keys six mois plus tard : tu sais à quoi elle correspond.
-f : le nom explicite qui évite le chaos
Le chemin de sortie (~/.ssh/id_ed25519_mon_pc) n’est pas qu’un détail. C’est l’organisation qui te permet de savoir quelle clé est où, et de révoquer vite quand une machine change.
Ce que je ne fais jamais : -N
Je ne passe jamais la passphrase en argument avec -N. Elle finirait dans l’historique de ton shell ou dans des logs. Tu la tapes au prompt, c’est plus sûr.
3) Passphrase obligatoire (et comment ne pas la rendre pénible)
Une clé SSH sans passphrase, c’est une clé privée qui peut ouvrir tes serveurs et qui traîne sur ton disque. Si un jour ta machine est compromise, la “sécurité au repos” disparaît.
Ma règle : toujours une passphrase forte. Et ensuite, on gère le confort avec ssh-agent.
Une clé SSH ne s’expire pas : attention aux clés oubliées dans authorized_keys
4) Le piège : une clé SSH n’expire jamais
Contrairement à un certificat TLS, une paire de clés SSH “classique” n’a pas de date de validité. Une fois que ta clé publique est dans authorized_keys, elle fonctionne indéfiniment jusqu’à ce que tu la retires.
Le vrai danger en homelab, ce n’est pas “la clé trop vieille”. C’est la clé oubliée : un ancien laptop revendu, une VM réinstallée, un téléphone perdu… et pourtant l’accès reste valide parce que personne n’a fait le ménage.
Deux solutions réalistes
Rotation manuelle : tu régénères tes paires périodiquement (par exemple une fois par an) et tu remplaces les clés publiques sur tes serveurs.
Certificats SSH : tu utilises une CA et des certificats avec une fenêtre de validité. Quand ça expire, le serveur refuse automatiquement.
Mon avis : pour un petit parc (un VPS + un NAS), monter une PKI complète peut être disproportionné. Mais dès que tu passes à plusieurs machines, l’approche certificats devient intéressante. Dans tous les cas, garde en tête une règle : audit régulier de qui a accès à quoi.
5) Combien de clés ? et combien de passphrases ?
On confond souvent deux décisions différentes : le nombre de clés et le nombre de passphrases. Elles ne répondent pas aux mêmes objectifs.
“Une clé par usage” ≠ “une clé par serveur”
Le bon découpage, ce n’est pas la destination (VPS, NAS, etc.). C’est le point de départ : quelle machine cliente et quel contexte.
Exemple de découpage sain :
PC       → id_ed25519_pc       (ouvre VPS, NAS, etc.)
Laptop   → id_ed25519_laptop   (ouvre VPS, NAS, etc.)
PC       → id_ed25519_github   (dédiée aux services tiers)
Pourquoi une clé dédiée pour GitHub / services tiers ? Parce que tu confies la clé publique à un tiers. Autant qu’elle ne soit pas réutilisée pour tes accès “maison”.
Une passphrase par machine (pas par clé)
La passphrase sert à protéger un fichier de clé privée volé. Si plusieurs clés vivent sur la même machine et partagent la même passphrase, un attaquant qui accède au disque pourra tenter cette passphrase pour toutes.
Mon conseil pragmatique : une passphrase forte et unique par machine cliente. Toutes les clés générées sur ce poste peuvent partager cette passphrase.
Deux exceptions où tu cloisonnes plus
Clé tierce (GitHub / services) : passphrase distincte si tu veux renforcer l’isolation.
Clé matérielle (ex. ed25519-sk) pour ton accès le plus sensible : la partie secrète ne peut pas être copiée depuis le disque. Là, la passphrase devient presque secondaire, parce que voler le fichier ne suffit plus.
6) ssh-agent : le confort sans sacrifier la sécurité
“Taper une passphrase à chaque connexion, c’est infernal.” Oui. Mais justement : on ne le fait pas. ssh-agent garde tes clés déchiffrées en mémoire le temps de la session.
Le but : tu tapes la passphrase une fois, puis tu enchaînes tes connexions sans friction.
ssh-agent garde les clés en mémoire pour éviter de retaper la passphrase
Résultat : à la première utilisation, SSH charge la clé dans l’agent. Ensuite, tu ne retapes pas la passphrase tant que l’agent vit.
Évite les mauvaises surprises : IdentitiesOnly yes
Quand tu as plusieurs clés, SSH peut essayer “trop de choses” et provoquer des refus côté serveur. Pour forcer la clé attendue, je recommande :
Host mon_serveur
  HostName ton.ip.ou.domaine
  User user_distant
  IdentityFile ~/.ssh/id_ed25519_mon_pc
  IdentitiesOnly yes
7) Bien gérer ssh-agent selon ton OS
Le problème n’est pas ssh-agent. Le problème, c’est le démarrage. Beaucoup de gens lancent ssh-add alors qu’aucun agent ne tourne, ou alors ils démarrent un agent sans appliquer les variables d’environnement.
Windows : l’agent persiste (souvent le plus simple)
Sur Windows, le service OpenSSH agent peut être configuré pour démarrer automatiquement. Ensuite, tu charges tes clés une fois, et elles reviennent après reboot.
Sur certaines configurations desktop, d’autres composants peuvent aussi gérer un agent. L’idée est de garder un contrôle clair sur “qui lance quoi”.
Mode ponctuel : le eval est obligatoire
Pour une tâche isolée, tu peux lancer un agent “jetable” dans ton terminal. Mais fais-le correctement :
eval "$(ssh-agent -s)"
Le eval applique les variables d’environnement dans ton shell courant. Sans ça, ton shell ne sait pas où joindre l’agent, et ssh-add échoue.
Arrêter proprement
Si tu as lancé l’agent proprement, tu peux le tuer avec :
ssh-agent -k
Si tu as lancé sans eval, tu peux te retrouver avec un agent qui tourne “dans le flou”. Dans ce cas, un nettoyage global peut être nécessaire :
pkill -u "$USER" ssh-agent
8) Sécurité ssh-agent : les deux réglages que je fais toujours
ssh-agent est pratique, mais il garde des clés déchiffrées en mémoire. Donc je limite l’exposition.
Timeout sur les clés sensibles
Tu peux demander à l’agent de purger une clé après un délai :
ssh-add -t 8h ~/.ssh/id_ed25519_mon_pc
Tu peux aussi mettre un comportement par défaut dans la config pour éviter les oublis.
Forwarding d’agent : prudence
Le forwarding d’agent (ForwardAgent yes ou ssh -A) permet au serveur distant d’utiliser ton agent pour rebondir ailleurs. C’est pratique, mais si le serveur est compromis, l’attaquant profite de ton agent tant que tu es connecté.
Je préfère une approche plus maîtrisée : ProxyJump pour le rebond, plutôt que le forwarding d’agent.
Nombre de clés : peu. Une par machine cliente, plus une dédiée aux services tiers.
Passphrases : une par machine (et éventuellement une distincte pour la clé tierce).
Confort : AddKeysToAgent yes + IdentitiesOnly yes quand nécessaire.
Rotation / nettoyage : les clés n’expirent pas, donc tu fais un audit et tu révoques vite.
Accès sensible : clé matérielle si tu veux le cran au-dessus.
Conclusion : reprendre le contrôle de tes accès
Les clés SSH ne sont pas un “détail de configuration”. Ce sont tes serrures. Et une serrure mal gérée, c’est un accès facile à long terme.
Si tu appliques cette méthode—Ed25519, passphrase, organisation claire, ssh-agent propre et audit régulier—tu réduis drastiquement le risque, tout en gardant un homelab fluide. La prochaine étape logique ? Faire l’inventaire de tes authorized_keys et vérifier que chaque clé correspond encore à une machine que tu contrôles.
bbDump fait partie des nouveautés qui méritent qu’on s’y attarde : un gestionnaire PostgreSQL pensé pour remplacer les réflexes CLI (pg_dump, pg_restore, navigation de schéma) par une interface plus directe… et qui va plus loin avec une intégration MCP pour les agents IA.
Ce que bbDump change vraiment par rapport à pgAdmin
On retrouve les fonctions attendues d’un client PostgreSQL : gestion multi-bases organisée par projet, backups (liste, restauration, filtres), et même une visionneuse de logs en temps réel pour suivre les opérations liées à pg_dump.
L’approche “moderne” se voit aussi dans l’ergonomie : navigateur de tables avec édition inline, constructeur de requêtes SQL (visuel + éditeur brut), export CSV, et un visualiseur ERD interactif pour comprendre rapidement une base héritée.
Interface bbDump : gestion PostgreSQL et couche MCP pour agents IA
Le twist : MCP pour brancher des agents IA sur votre base
Le point le plus intéressant côté veille, c’est l’intégration MCP. bbDump expose 31 outils MCP permettant à des agents (type Claude ou autres LLM) d’interroger la base : consulter le schéma, explorer, et tester des requêtes.
Et surtout, les mutations passent par un mécanisme de confirmation : l’idée est de réduire le risque d’actions destructrices faites “à l’aveugle”.
Sécurité et disponibilité : ce qu’il faut vérifier avant d’adopter
Backups chiffrés en AES-256-GCM.
Projet jeune : disponible sur macOS et Linux en beta.
Windows n’est pas encore supporté.
Si vous administrez PostgreSQL et que vous cherchez une alternative plus fluide, bbDump mérite un test — surtout pour ceux qui veulent combiner DB tooling et agents IA, sans sacrifier la prudence.
Prochaine étape : voir comment l’intégration MCP s’insère dans vos workflows (revue de requêtes, validation, automatisations) et si l’UX tient la distance sur des bases “réelles”.