HackerBooks : les livres recommandés sur Hacker News

Vous cherchez un livre de programmation, de maths ou simplement une idée de lecture qui sort des classements habituels ? HackerBooks rassemble les ouvrages évoqués sur Hacker News depuis 2007. L’intérêt n’est pas seulement de voir quels titres reviennent souvent : le site essaie aussi de distinguer un livre cité au détour d’une discussion d’un livre réellement conseillé. Et cette nuance change pas mal de choses.

HackerBooks transforme les discussions en bibliothèque

Les utilisateurs de Hacker News échangent depuis des années des recommandations dans les commentaires. Le problème, c’est qu’une bonne suggestion peut vite disparaître sous une pile de nouvelles discussions. HackerBooks remet de l’ordre dans tout ça : 15 766 livres ont été recensés à partir de 281 363 mentions publiées depuis 2007.

Pour figurer dans la bibliothèque, un ouvrage doit avoir été cité par au moins deux personnes différentes. Ce seuil ne garantit pas qu’il soit excellent, bien sûr, mais il évite de construire tout un catalogue sur des mentions isolées. On obtient ainsi un point d’entrée pratique pour retrouver des livres dont plusieurs personnes ont parlé.

Les ouvrages sont répartis dans des rubriques comme la programmation, les mathématiques, la philosophie ou la fiction. Chaque fiche permet aussi de revenir aux commentaires associés. C’est à mon avis la partie la plus utile : un titre seul donne une piste, une discussion aide à comprendre pourquoi il mérite votre temps.

Une citation n’est pas une recommandation

C’est le piège classique des classements fondés sur la popularité. Un livre peut être mentionné parce qu’il a marqué un domaine, parce qu’il suscite un désaccord ou simplement parce qu’il répond à une question précise. Compter toutes ces occurrences comme des recommandations donnerait une image trompeuse.

HackerBooks utilise l’IA pour séparer les citations des recommandations. Prenez The Art of Computer Programming, de Donald Knuth : 1 125 personnes l’ont cité, mais 336 l’ont recommandé. Le premier chiffre mesure sa présence dans les conversations ; le second tente de mesurer l’envie de le conseiller. Ce n’est pas du tout la même information.
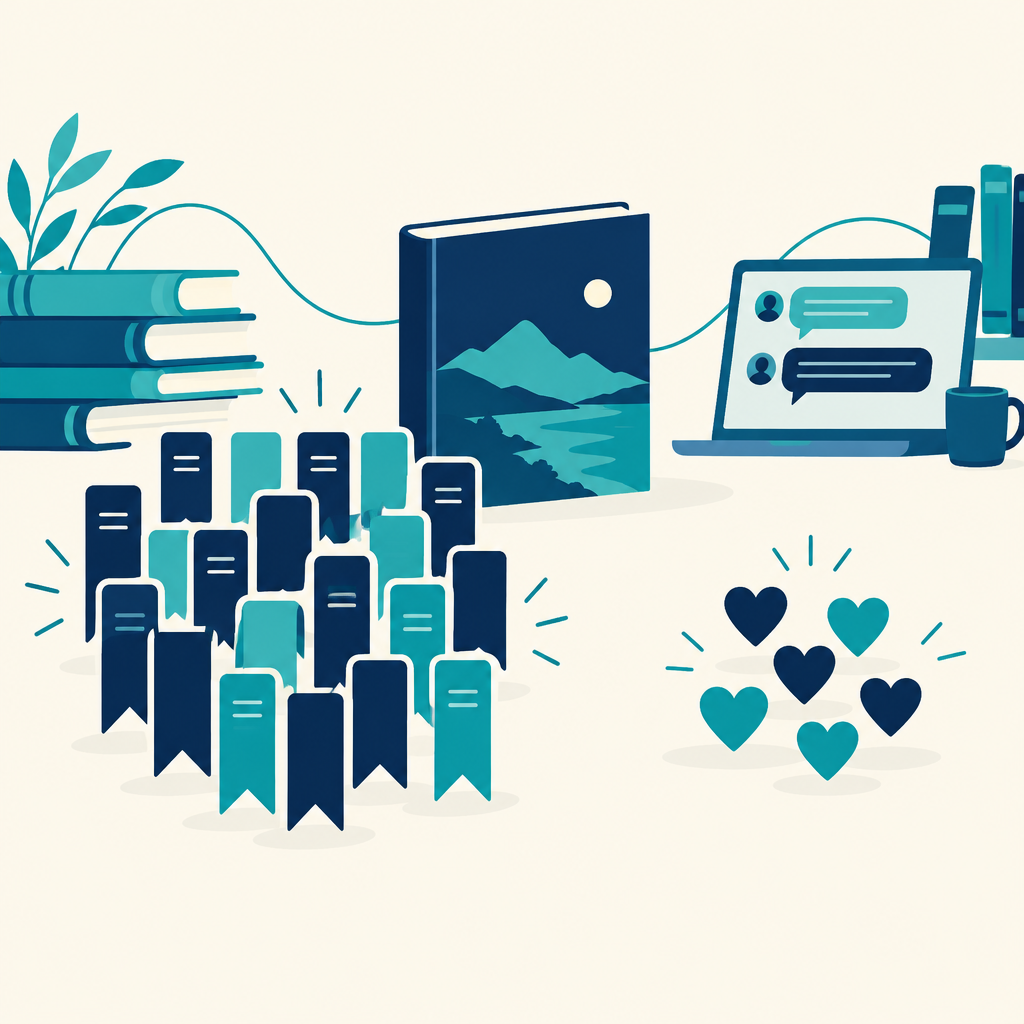
Différence entre citations et recommandations de livres dans HackerBooks

J’aime bien cette distinction parce qu’elle pousse à regarder derrière les chiffres. Si vous cherchez votre prochaine lecture, un ouvrage très cité n’est pas automatiquement celui par lequel commencer. Il vaut mieux lire quelques commentaires pour voir à qui il s’adresse, ce que les lecteurs en ont retenu et dans quel contexte ils le proposent.

Comment trouver une lecture qui vous correspond ?

Une grosse bibliothèque peut rapidement devenir une nouvelle façon de perdre du temps. Le plus simple est de partir d’un besoin concret, puis de confronter les suggestions aux discussions. Par exemple :

  • Choisissez une rubrique liée à ce que vous voulez découvrir ou approfondir.
  • Repérez les livres recommandés, sans vous arrêter au nombre total de citations.
  • Ouvrez les commentaires pour comprendre les avis et le niveau attendu.
  • Comparez plusieurs titres avant de décider lequel vous donnera vraiment envie de lire.

Le site propose aussi des suggestions personnalisées en fonction des fiches ouvertes. Cela peut aider à prolonger l’exploration, surtout quand un ouvrage vous intrigue sans être exactement ce que vous cherchiez. Mais je garderais la main sur le choix final : une suggestion automatique connaît vos clics, pas forcément vos objectifs.

Une bonne idée, à utiliser avec un peu de recul

HackerBooks a été codé avec Claude à la demande de Roansh. Dans le même esprit, HackerTube rassemble des vidéos recommandées sur Hacker News. Je trouve ces projets intéressants parce qu’ils donnent une forme utilisable à des années d’échanges dispersés. L’IA sert ici à organiser et à trier, plutôt qu’à inventer une liste de lectures sortie de nulle part.

Il reste une précaution importante : le classement des recommandations repose sur une interprétation automatique. Le contexte d’un commentaire peut être subtil, et un livre peut être confondu avec un autre. Si une fiche vous semble étrange, les discussions restent le meilleur endroit pour vérifier ce que les personnes voulaient dire. Il est également possible de signaler une erreur au créateur du site.

Enfin, HackerBooks n’est pas une bibliothèque de fichiers à télécharger : les fiches orientent vers des vendeurs de livres. Son intérêt est ailleurs, dans la découverte et dans l’accès aux échanges autour des ouvrages. Si vous avez envie d’apprendre quelque chose de nouveau, c’est une bonne porte d’entrée. Reste ensuite le plus difficile : choisir un livre, le commencer et aller jusqu’au bout.

Source : https://korben.info/hackerbooks-hackertube-hacker-news.html
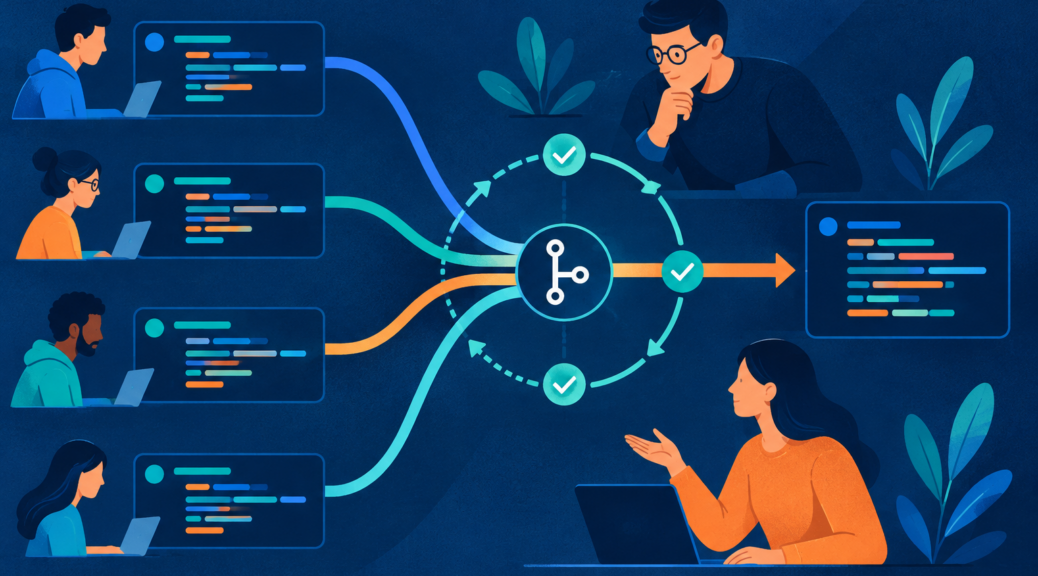
Trunk-based development : la fin des pull requests

Le trunk-based development revient dans les discussions dès qu’on parle de code produit avec l’aide de l’IA. Puisque les modifications arrivent plus vite, pourquoi attendre une pull request, une revue et une fusion pour les intégrer ? Mais supprimer une étape ne supprime pas le travail qu’elle accomplissait. Il faut décider où placer ce travail, et comment vérifier qu’il est bien fait.

Je préfère une petite modification intégrée rapidement à une grosse pull request qui attend plusieurs jours. Pour autant, je ne donnerais pas les clés de la branche principale à toute l’équipe au seul motif qu’un assistant IA aide à écrire le code. La vitesse est utile si elle réduit aussi le délai entre une erreur et sa détection.

Trunk-based development : ce qu’on change vraiment

Le principe du trunk-based development consiste à intégrer fréquemment de petites modifications dans une branche principale commune. On évite ainsi que chacun travaille trop longtemps dans son coin, avec une branche qui diverge progressivement du reste du projet. Ce n’est pas forcément « plus de branches du tout » : des branches très courtes peuvent garder leur place.

La différence importante se situe dans la taille et la durée de vie du travail isolé. Une branche ouverte pour quelques heures et une pull request relue rapidement restent compatibles avec cette logique. À l’inverse, une fonctionnalité complète développée pendant des semaines avant fusion rend l’intégration plus risquée, même si elle passe par une revue formelle.

Le débat « pull requests ou trunk » devient trompeur quand il oppose deux boutons dans une interface Git. Une pull request est un moyen de discuter et de contrôler une modification. Le trunk-based development est une manière d’organiser le flux de travail.

Ce que l’IA accélère, et ce qu’elle ne vérifie pas

Un assistant peut proposer du code, des tests ou une première explication d’un changement. C’est pratique pour avancer. Mais une proposition rapide n’est pas automatiquement une modification pertinente. Il reste à vérifier qu’elle répond au besoin, s’intègre au projet et ne dégrade pas un comportement moins visible.

C’est là que je serais prudent avec l’idée de rendre les pull requests obsolètes. Si l’IA augmente le volume de code produit, elle peut aussi augmenter le volume de code à comprendre. Déplacer ce volume directement sur la branche principale, sans ajuster les contrôles, ne me semble pas être un progrès.

Avant d’intégrer une modification, je garderais au minimum quelques questions en tête :

  • Le changement est-il assez petit pour être compris et annulé facilement ?
  • Les tests vérifient-ils le comportement qui compte, et pas seulement le chemin le plus évident ?
  • Une personne connaît-elle la raison du changement, même si l’IA a participé à son écriture ?
  • Que se passe-t-il si cette modification casse quelque chose après l’intégration ?

Ces questions ne réclament pas nécessairement une longue revue asynchrone. Elles réclament en revanche une réponse. Selon les équipes, elle peut prendre la forme d’une revue courte, d’un échange en binôme, de contrôles automatisés ou d’une combinaison des trois.

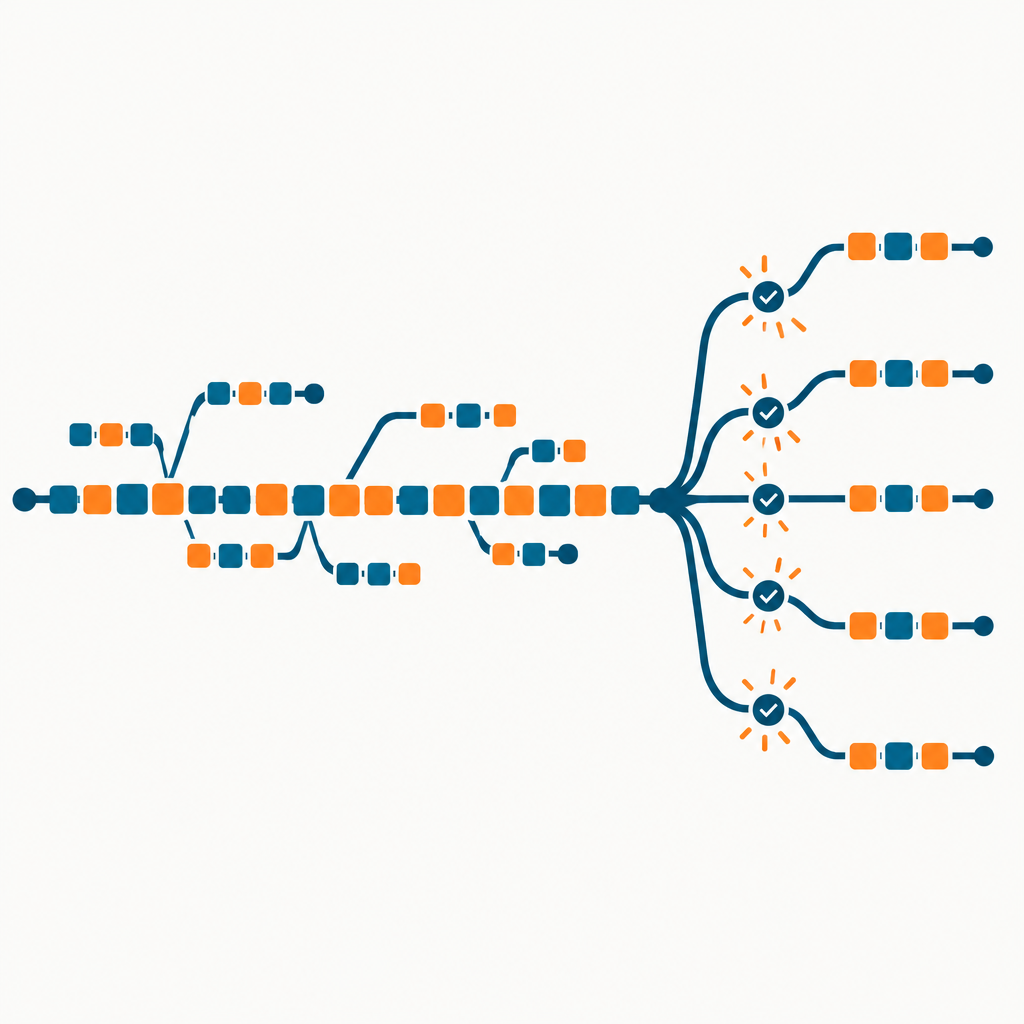
Comparaison visuelle entre branche longue et intégrations fréquentes sur le trunk

Des petits changements, pas des contrôles en moins

À mes yeux, le principal intérêt du trunk-based development n’est pas de gagner quelques clics dans Git. C’est de rendre chaque changement assez limité pour qu’on puisse le comprendre, le tester et, si besoin, revenir en arrière. La taille des modifications devient alors un outil de maîtrise du risque.

Prenons une fonctionnalité qui touche à la base de données, au traitement métier et à l’interface. Tout livrer d’un coup complique la revue comme le diagnostic en cas de problème. La découper en étapes cohérentes permet de vérifier chaque partie plus tôt. Mais il faut préparer ces étapes : un changement intermédiaire ne doit pas casser le fonctionnement existant.

Les feature flags peuvent aider à séparer l’intégration du code de l’activation d’une fonctionnalité. Le code rejoint la branche principale, tandis que la nouveauté reste désactivée pour les utilisateurs concernés jusqu’à ce qu’elle soit prête. Ce n’est pas une solution magique : les états activé et désactivé doivent être testés, et les flags devenus inutiles doivent être retirés.

Je retiens surtout une règle pratique : si une modification paraît impossible à intégrer sans tout terminer auparavant, il faut regarder si on peut la découper autrement. Ce n’est pas toujours facile, notamment lorsqu’une migration touche plusieurs composants. Mais cette difficulté mérite d’être traitée comme un problème de conception, pas cachée dans une branche de longue durée.

Ce qu’il faut préparer avant de changer de méthode

Intégrer plusieurs fois par jour suppose une branche principale sur laquelle l’équipe peut travailler sans appréhension. Pour y parvenir, il faut plus qu’une consigne du type « faites des petits commits ». Les tests doivent être utiles, leur résultat doit arriver assez vite, et un échec doit être pris en charge rapidement.

Je commencerais par observer le fonctionnement actuel plutôt que par interdire les pull requests. Combien de temps une modification attend-elle une revue ? Quelle taille font les changements difficiles à relire ? Quels tests échouent régulièrement sans signaler un vrai problème ? Ces questions montrent où le travail ralentit et où la confiance manque.

Ensuite, je ferais évoluer les habitudes progressivement :

  1. Découper une tâche en changements plus petits, chacun avec un objectif compréhensible.
  2. Automatiser les vérifications que l’équipe répète déjà à chaque revue.
  3. Conserver une intervention humaine ciblée sur les choix de conception, les cas sensibles et les risques métier.
  4. Prévoir comment désactiver une fonctionnalité ou revenir sur un changement problématique.
  5. Vérifier régulièrement si le délai d’intégration baisse sans multiplier les incidents.

Ce dernier point est important. Une équipe peut fusionner beaucoup plus vite tout en passant davantage de temps à réparer. Elle n’a alors fait que déplacer l’attente : elle n’est plus devant la pull request, elle se retrouve après la mise en production.

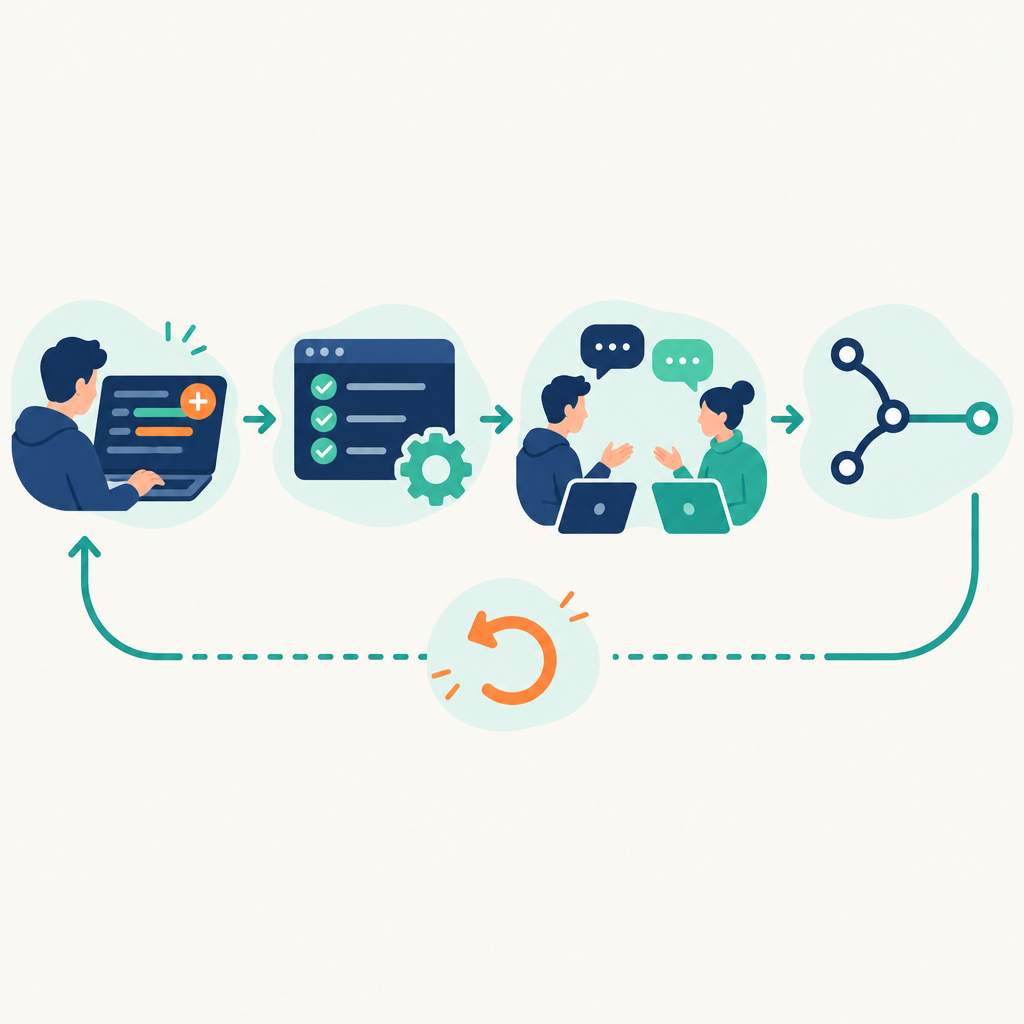
Flux de vérification et d’intégration de petits changements de code

Faut-il vraiment supprimer les pull requests ?

Je ne le ferais pas par principe. Dans une petite équipe qui échange souvent, une revue rapide avant fusion peut rester légère et utile. Dans un projet ouvert aux contributions extérieures, la pull request offre aussi un espace clair pour expliquer le changement et en discuter. Et certains changements sensibles justifient un contrôle explicite avant d’atteindre la branche principale.

En revanche, une pull request qui reste ouverte longtemps parce que personne n’a le temps de la lire ne protège pas grand-chose. Elle accumule les conflits, retarde les retours et finit parfois par être validée dans l’urgence. Dans ce cas, la bonne réponse n’est pas nécessairement de supprimer les revues : c’est de réduire leur taille et de leur réserver une vraie place dans le travail de l’équipe.

L’IA rend cette discipline encore plus importante. Si produire une modification prend moins de temps, comprendre pourquoi elle existe et vérifier ses effets ne doit pas devenir une formalité. La responsabilité du code reste humaine, qu’il ait été écrit à la main ou suggéré par un outil.

Au fond, je ne choisirais pas entre « tout passe par une pull request » et « tout part directement sur le trunk ». Je chercherais le circuit le plus court qui permette encore de comprendre, tester et corriger chaque changement. C’est moins spectaculaire qu’une révolution des méthodes de développement, mais probablement plus utile au quotidien.

Source : https://alm.developpez.com/actu/388617/Des-developpeurs-estiment-que-les-Pull-Requests-sont-obsoletes-a-l-ere-de-l-IA-et-proposent-d-aller-au-Trunk-Based-Development-Tout-le-monde-integre-son-travail-sur-une-seule-branche-plusieurs-fois-par-jour/